보이스봇, 상담사 화면에 올라오는 실시간 대화록, 통화가 끝나면 저절로 채워지는 요약문. 겉모습은 전혀 다르다. 그런데 뜯어 보면 같은 부품으로 만들어져 있다. 소리를 글자로 바꾸는 부품, 글자를 소리로 바꾸는 부품, 글자를 다루고 알아듣는 부품. 그리고 그 부품들에 소리를 대 주는 장치가 하나 있다. 녹취다. 센터에 인공지능을 넣을 때 먼저 정할 것이 어느 봇을 살지가 아니라 이 부품들을 어떻게 갖출지인 이유가 여기에 있다.
지난 글에서 인공지능 컨택센터(AICC)를 한 장의 지도로 그렸다. 인공지능은 상담사 책상의 세 자리에 앉는다. 상담사보다 먼저 받는 앞자리, 통화 중에 거드는 옆자리, 통화 뒤에 정리하는 뒷자리. 전화를 대신 받는 앞자리는 눈에 띄고, 옆자리와 뒷자리는 눈에 띄지 않지만 효과는 그쪽이 꾸준하다. 이 글은 그 세 자리가 공통으로 쓰는 재료와, 재료에 소리를 공급하는 녹취를 본다. 요소의 이름은 다음 글부터 하나씩 나오고, 여기서는 그 요소들이 무엇으로 만들어지는지만 본다.
재료 세 가지, 소리를 글자로∙글자를 소리로∙글자를 다루기
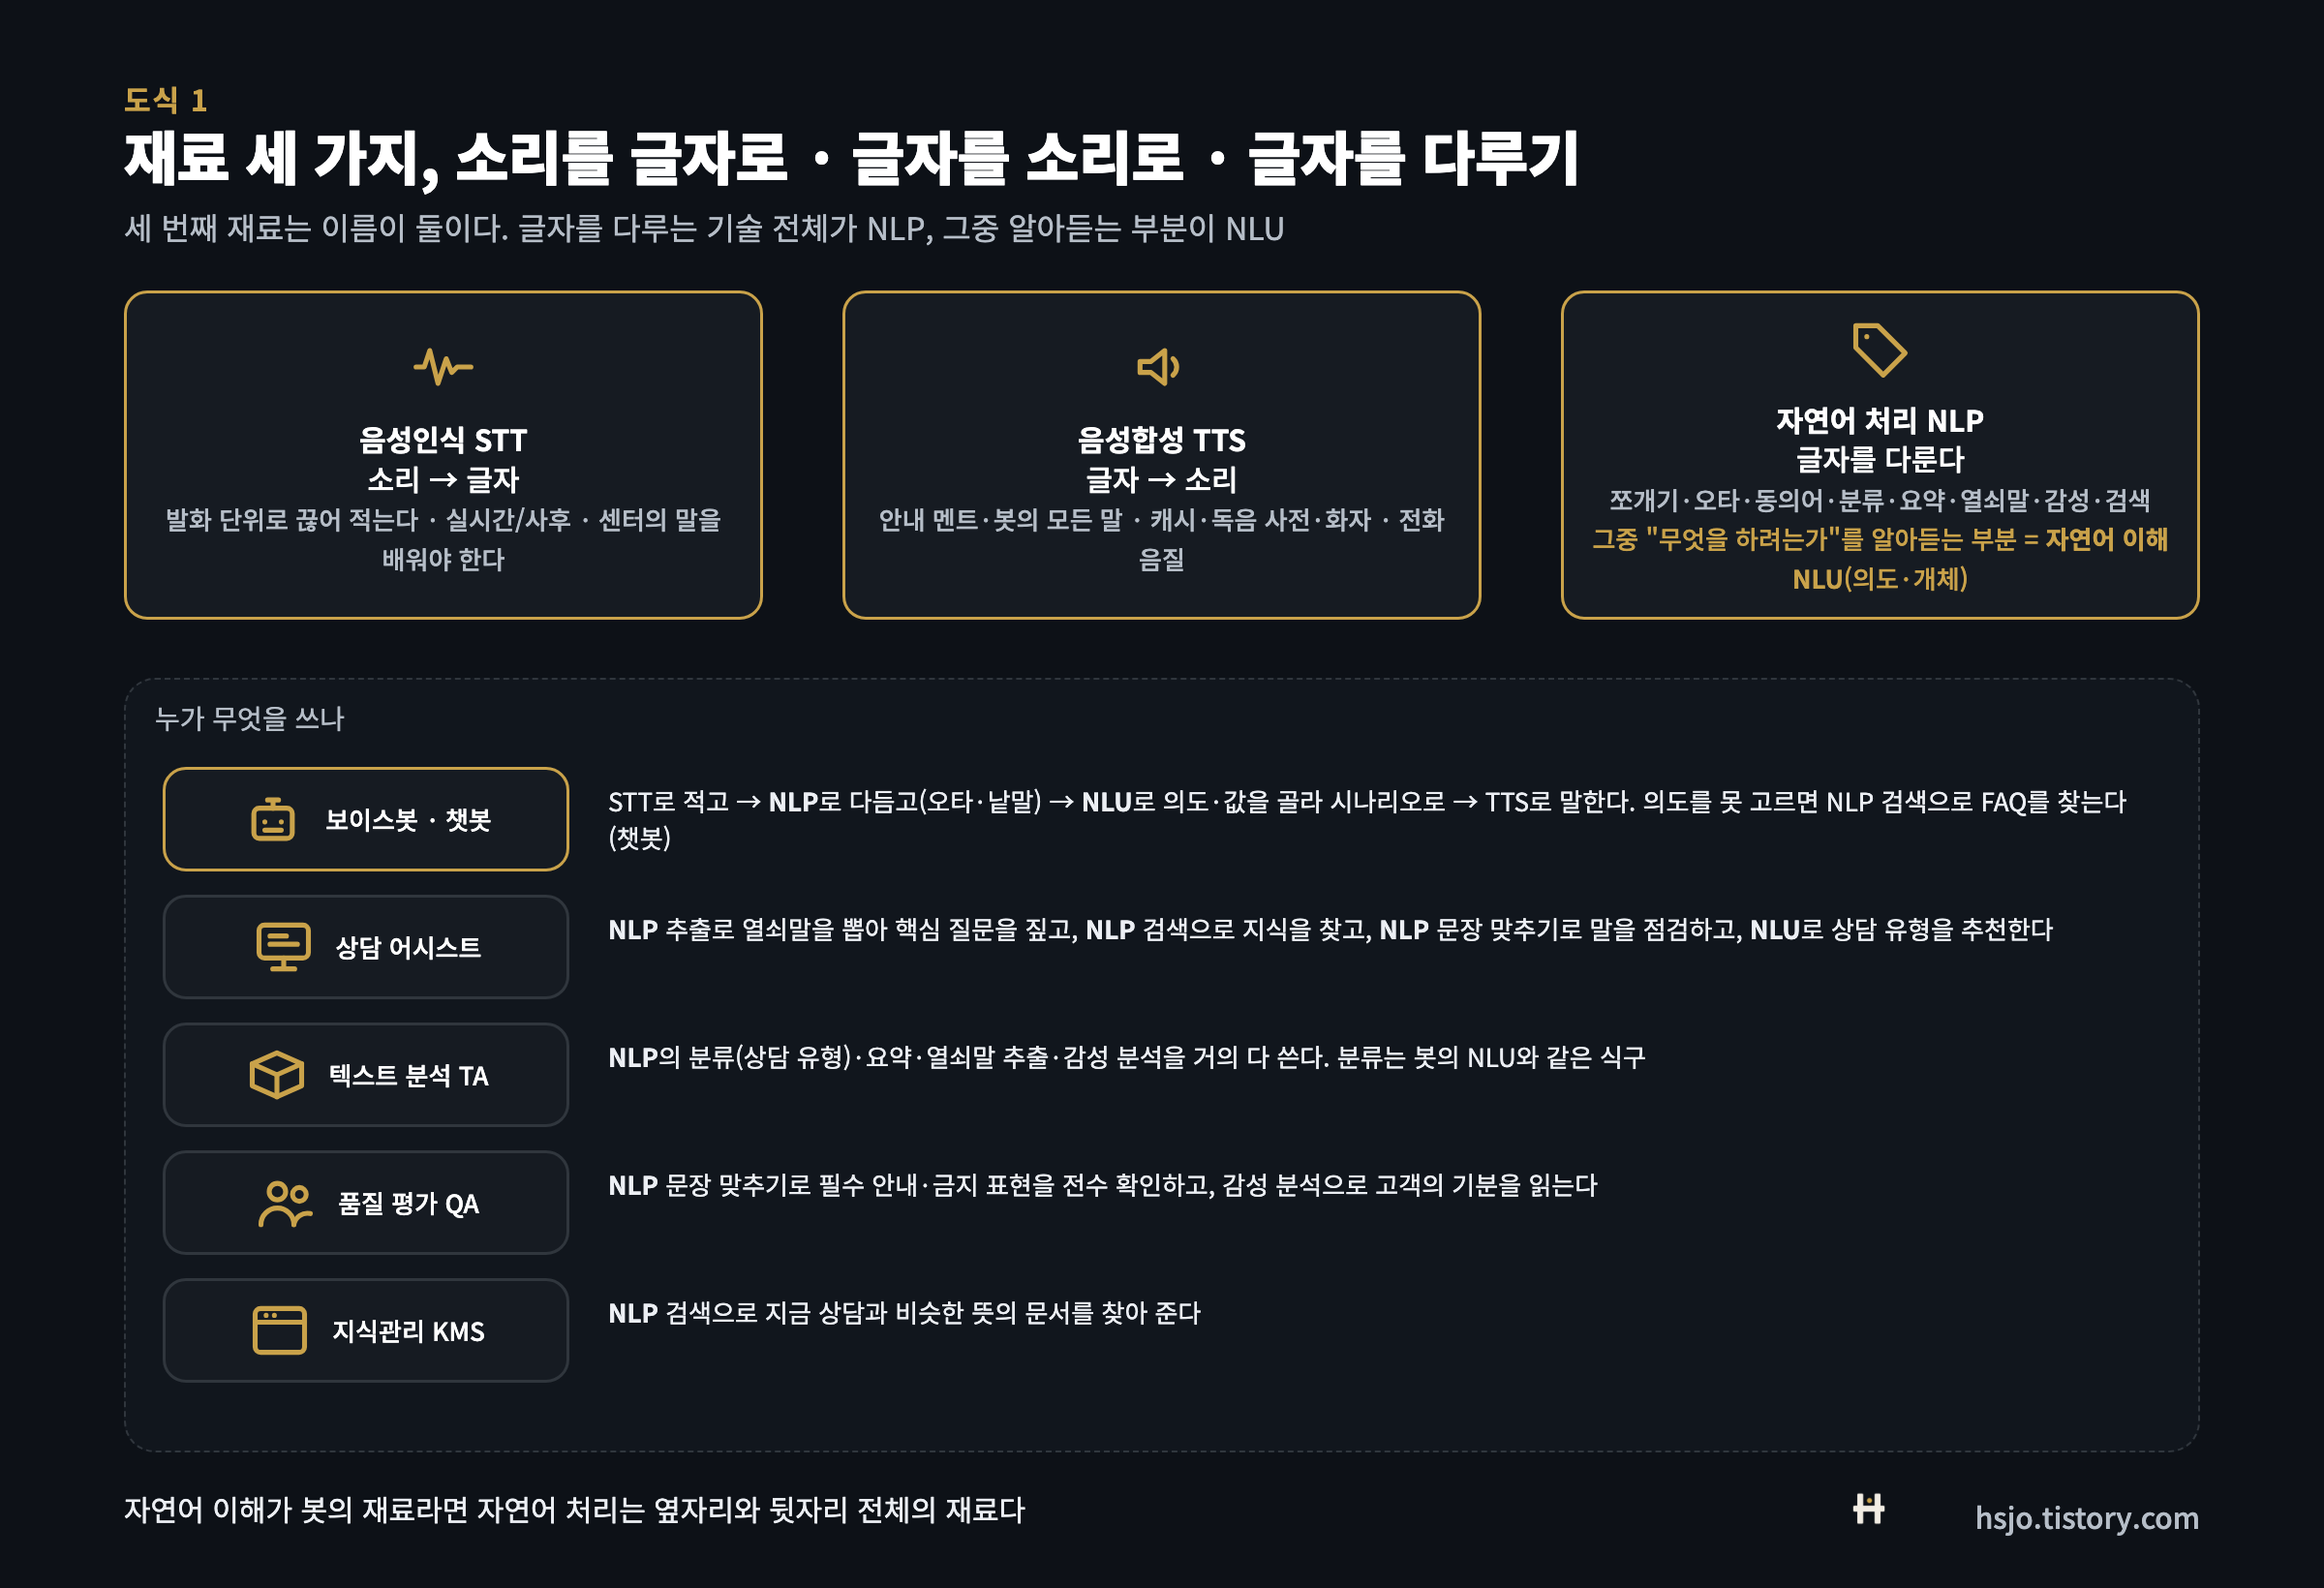
인공지능 컨택센터의 구성 요소는 이름이 많지만 재료는 셋이다. 소리를 글자로 바꾸는 음성인식, 글자를 소리로 바꾸는 음성합성, 그리고 글자를 다루는 기술. 세 번째 재료는 이름이 둘이다. 글자를 다루는 기술 전체를 자연어 처리(NLP)라고 부르고, 그중 "무슨 뜻인지 알아듣는" 부분을 자연어 이해(NLU)라고 부른다. 둘을 섞어 쓰는 자료가 많아 처음 배우는 사람이 가장 헷갈리는 자리라 따로 풀어 쓴다. 보이스봇은 세 재료를 다 쓰고, 상담사 옆자리와 뒷자리는 주로 음성인식과 자연어 처리를 쓴다. 재료가 같으니 센터 하나에 음성인식 엔진은 보통 하나다. 봇도 그것을 쓰고 상담사 옆자리도 그것을 쓴다. 이 셋을 모르면 뒤의 모든 요소가 블랙박스로 보인다.
음성인식(STT, Speech To Text). 전화에서 흘러온 소리를 글자로 적는다. 사람이 받아쓰는 속기사와 같은 일인데, 다른 점이 셋 있다.
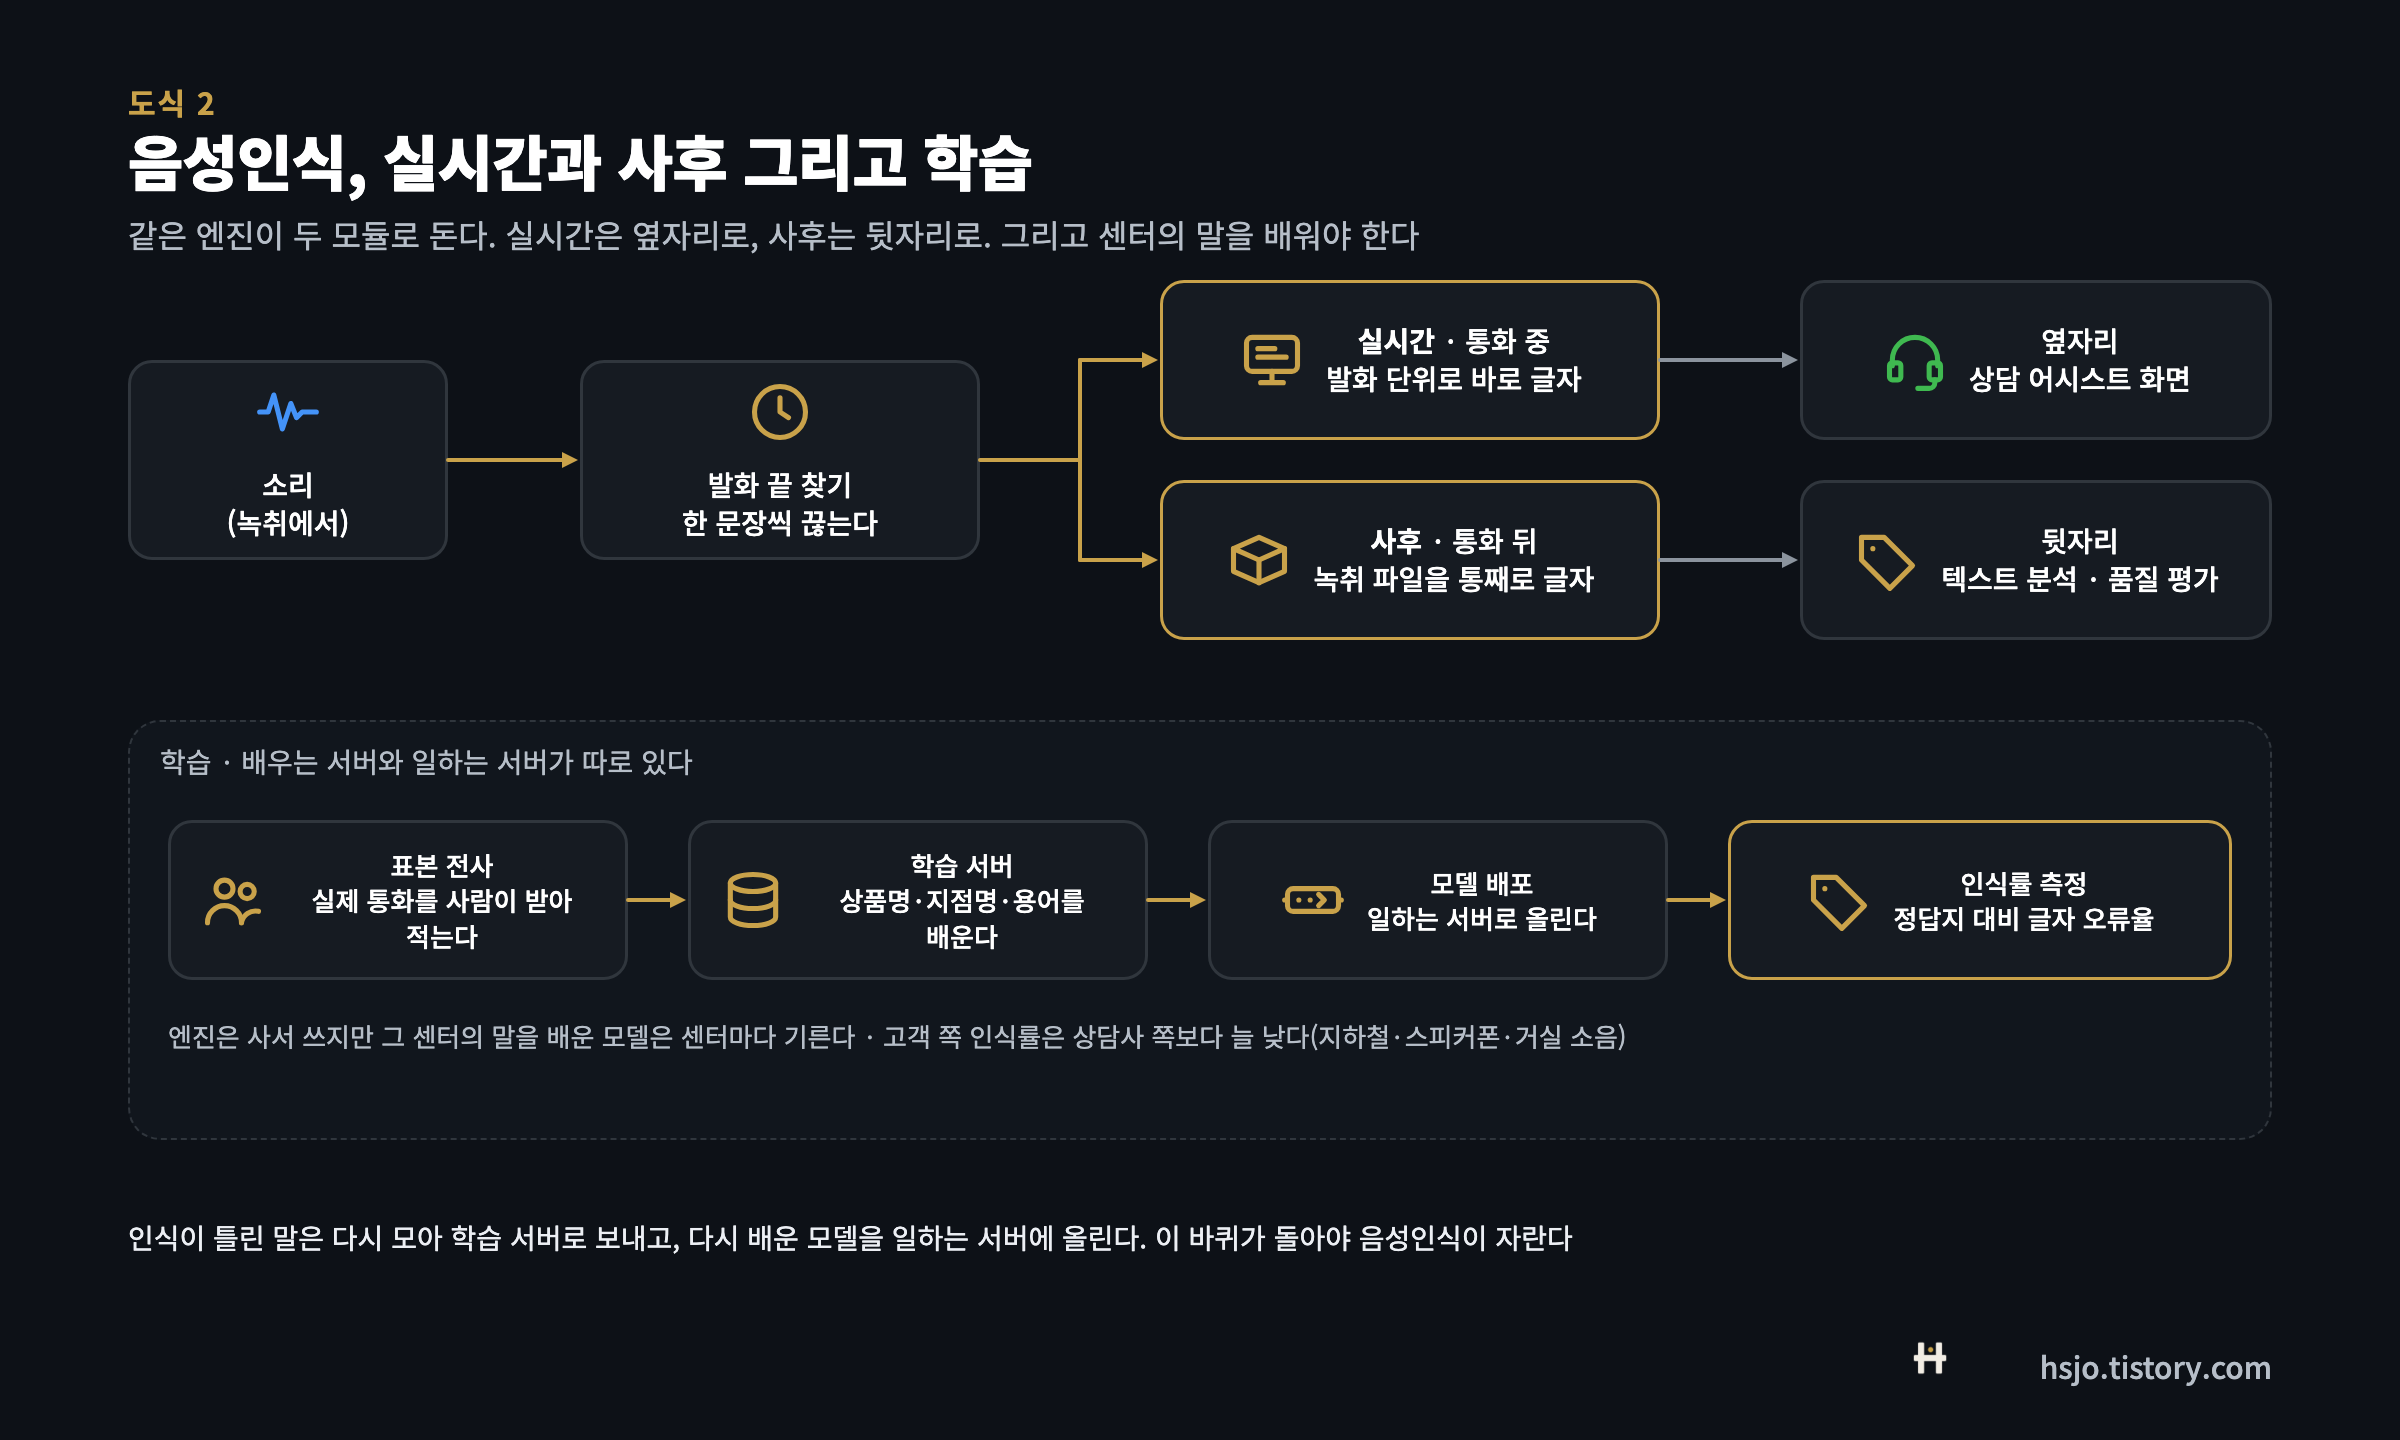
첫째, 문장 단위로 끊는다. 말이 멈추는 지점(발화 끝)을 찾아 그 사이를 한 덩어리로 글자로 바꾼다. 상담사 화면에 말풍선이 한 개씩 올라오는 것은 이 덩어리 하나가 끝날 때마다다. 둘째, 두 가지 방식으로 돈다. 통화 중에 바로바로 적는 실시간 방식과, 통화가 끝난 뒤 녹취 파일을 통째로 적는 사후 방식이다. 둘은 같은 엔진을 쓰지만 다른 모듈이고 다른 자리에 쓰인다. 실시간은 옆자리로, 사후는 뒷자리로 간다. 셋째, 배워야 한다. 처음 가져온 음성인식은 일반 말은 잘 알아듣지만 그 센터의 상품 이름, 지점 이름, 전문 용어, 오류 코드는 자주 틀린다. 그래서 그 센터의 실제 통화를 사람이 받아 적은 표본으로 가르친다. 배우는 서버와 일하는 서버가 따로 있는 이유다.
인식률은 "잘 알아듣는 것 같다"로 재지 않고 그 정답지와 글자 단위로 견주어 오류율로 잰다. 솔직히 이 숫자는 늘 기대보다 낮게 나온다. 상담사의 말은 헤드셋으로 또렷하게 들어오지만 고객의 말은 지하철에서, 스피커폰으로, 아이가 우는 거실에서 들어오기 때문이다. 고객 쪽 인식률이 상담사 쪽보다 늘 낮다. 그리고 엔진은 사서 쓰지만 그 센터의 말을 배운 모델은 센터마다 다시 기른다.
음성합성(TTS, Text To Speech). 글자를 소리로 읽는다. 전화를 받으면 먼저 나오는 IVR의 안내 멘트는 원래 성우가 녹음한 파일이었다. 멘트가 바뀔 때마다 성우를 다시 부를 수 없으니, 글자만 고치면 소리가 나오는 음성합성이 그 자리를 대신해 왔다. 보이스봇 이전에도 IVR 옆에는 음성합성 서버가 있었다. 보이스봇은 이것을 훨씬 많이 쓴다. 봇이 하는 모든 말이 글자에서 시작하기 때문이다.
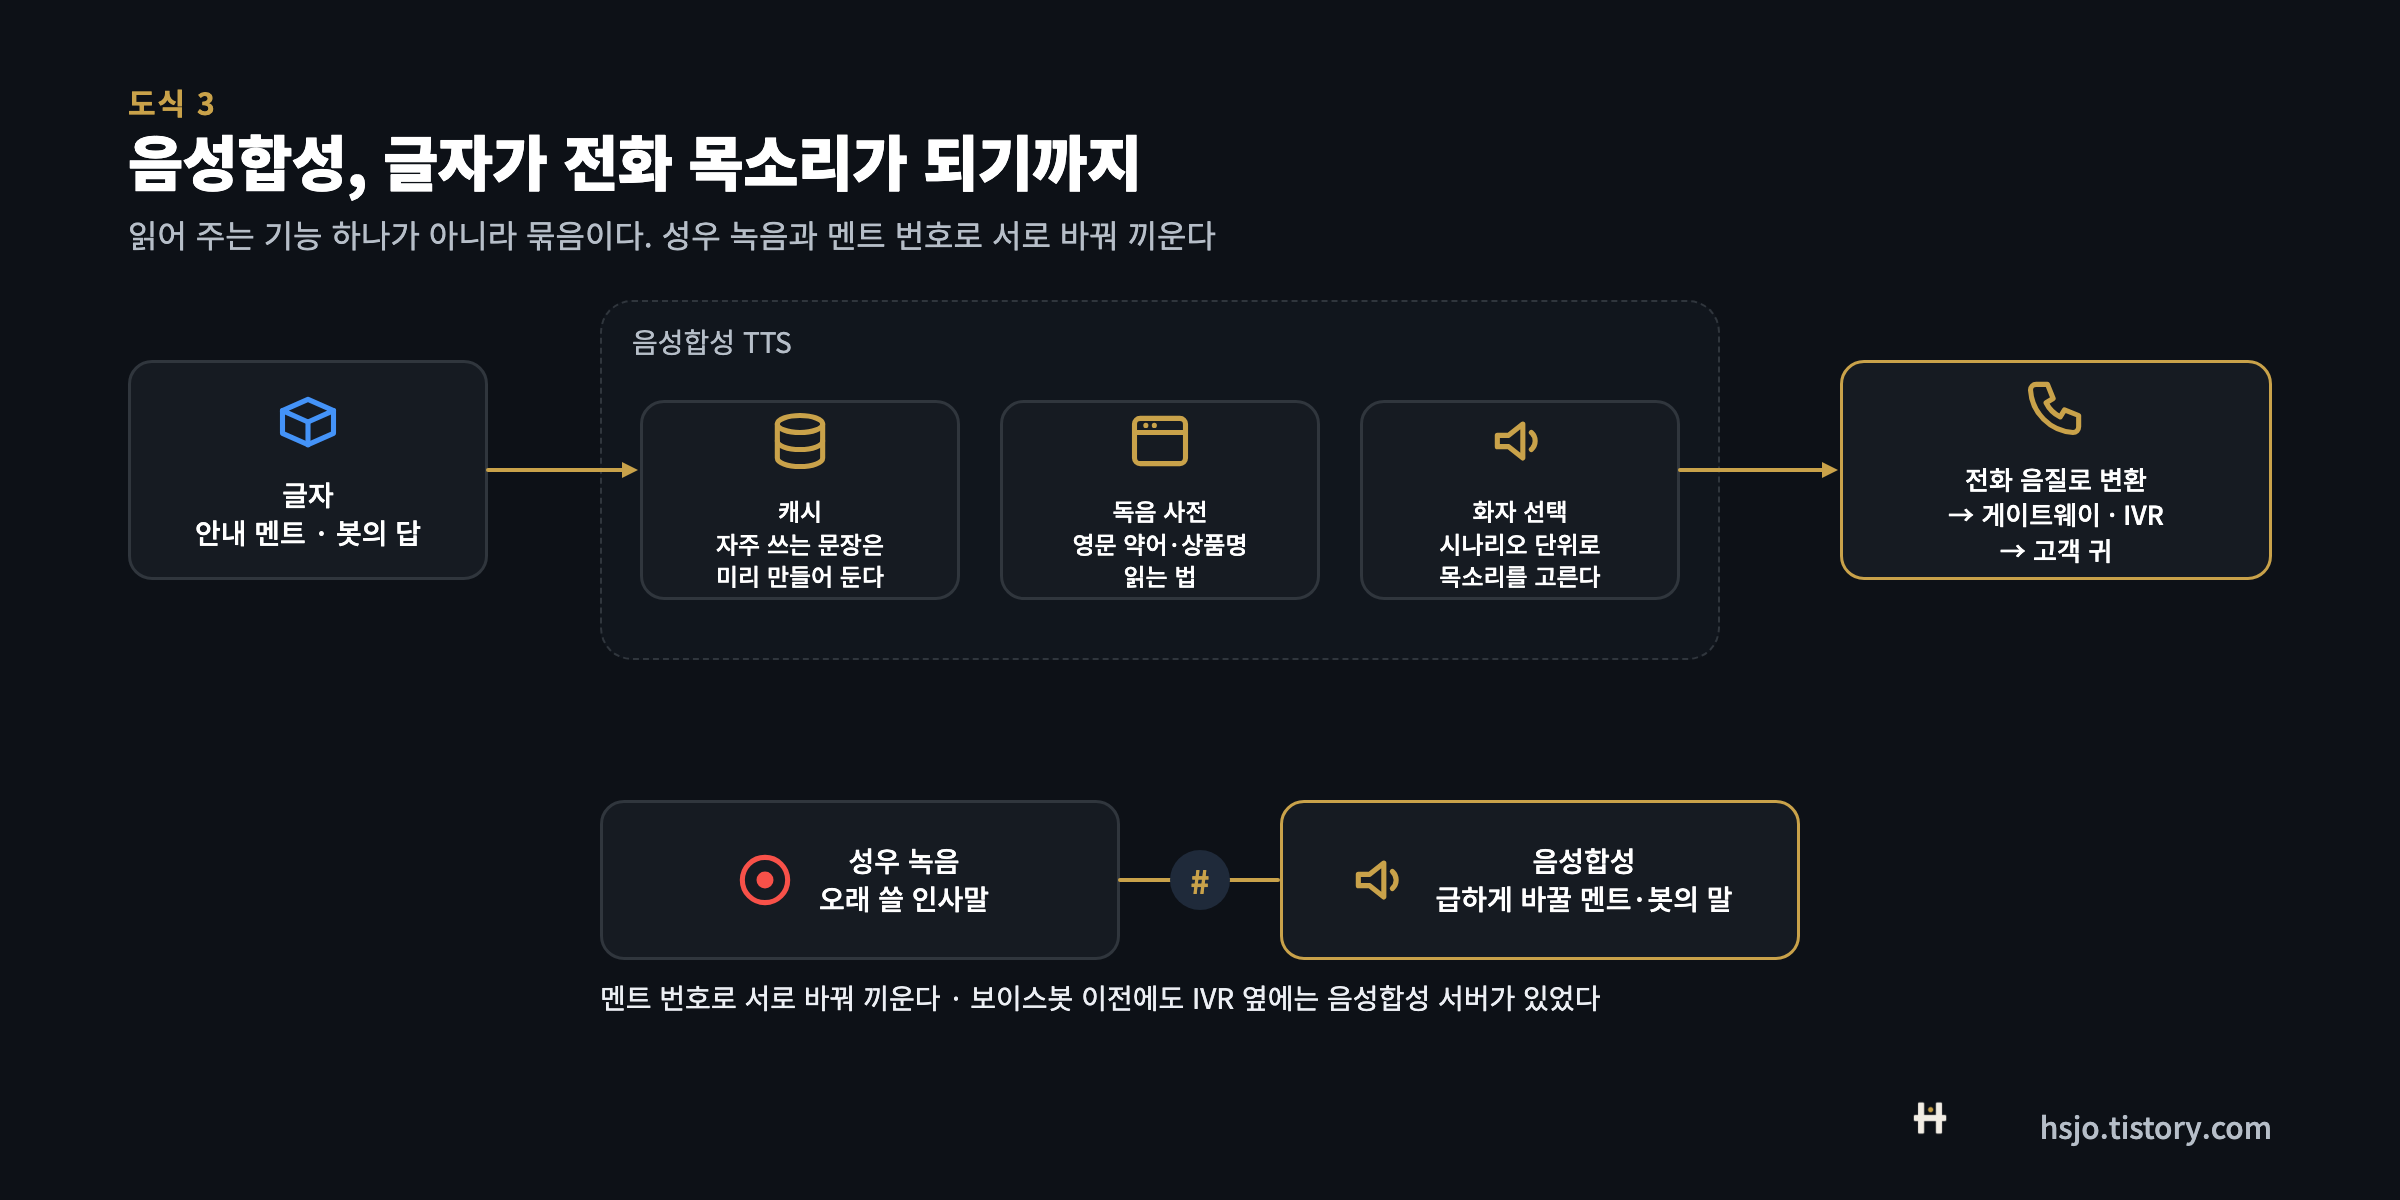
현장에서 음성합성은 "읽어 주는 기능" 하나가 아니라 묶음이다. 자주 쓰는 문장은 미리 만들어 저장해 두고 꺼내 쓴다. 그래야 봇의 첫마디가 늦지 않는다. 영문 약어나 상품명은 어떻게 읽을지 사전에 적어 둔다. 목소리는 시나리오 단위로 고른다. 그리고 전화망에 맞게 소리를 낮춘다. 전화는 음악을 듣는 길이 아니라서 소리의 결이 거칠다. 음성합성이 아무리 고운 소리를 만들어도 전화기에서는 전화 음질로 들린다. 성우 녹음과 음성합성은 멘트 번호로 서로 바꿔 끼울 수 있게 둔다. 급하게 바꿀 멘트는 합성으로, 오래 쓸 인사말은 녹음으로 가는 식이다.
자연어 처리(NLP, Natural Language Processing). 글자를 다루는 기술 전체의 이름이다. 국어 선생님이 하는 일을 떠올리면 된다. 문장을 낱말로 쪼개고(형태소 분석), 오타를 고치고, 같은 뜻의 다른 말을 알아보고(동의어 사전), 글이 무엇에 관한 글인지 가르고(분류), 중요한 낱말을 뽑고(열쇠말 추출), 긴 글을 짧게 줄이고(요약), 글의 기분을 읽고(감성 분석), 비슷한 글을 찾는다(검색). 컨택센터에서 음성인식이 만든 글자는 전부 이 기술을 한 번 이상 거친다. 상담 유형을 나누는 것도, 통화를 몇 줄로 줄이는 것도, 이번 달 많이 나온 낱말을 세는 것도, 지식 중에서 지금 상담에 맞는 문서를 찾는 것도 자연어 처리다.
자연어 이해(NLU, Natural Language Understanding). 자연어 처리 중에서 "이 사람이 무엇을 하려는가"를 알아듣는 부분이다. "보험금 청구가 어디까지 됐나요"에서 의도는 "청구 진행 조회"다. 문장 안의 값도 함께 뽑는다. 날짜, 금액, 번호, 지점 이름. 이것을 개체라고 부른다. 자연어 이해는 의도마다 예문을 수십 개씩 넣어 가르치고, 그 앞에 자연어 처리의 오타 사전과 동의어 사전을 붙여 "청구"와 "청구금"과 "보험금"이 같은 뜻임을 알게 한다. 봇이 "다시 한번 말씀해 주세요"라고 하는 순간은 대개 음성인식이 아니라 여기서 막힌 순간이다. 글자는 제대로 적혔는데 어느 의도인지 못 고른 것이다. 자연어 처리가 글자를 "다루는" 기술이라면 자연어 이해는 그중 글자를 "알아듣는"기술이고, 봇은 알아들어야 다음 말을 고를 수 있어서 자연어 이해를 쓴다.
누가 무엇을 쓰는지 미리 적어 두면 뒤의 글이 읽기 쉽다. 보이스봇과 챗봇은 자연어 이해를 쓴다(고객의 말이 어느 의도인지 골라야 시나리오로 갈 수 있다). 상담 어시스트는 자연어 처리로 열쇠말을 뽑아 핵심 질문을 짚고 지식을 찾고, 자연어 이해로 상담 유형을 추천 한다. 텍스트 분석은 자연어 처리의 분류∙요약∙열쇠말∙감성 분석을 거의 다 쓴다. 품질 평가는 자연어 처리로 필수 문장이 있는지 맞춰 보고 고객의 기분을 읽는다. 지식관리는 자연어 처리의 검색을 쓴다. 자연어 이해가 봇의 재료라면 자연어 처리는 옆자리와 뒷자리 전체의 재료다.
녹취, 인공지능이 소리를 받는 자리

녹취 서버는 상담사에게 전화가 연결되는 순간부터 통화의 소리(RTP)를 복사해 저장한다. 원래 그것은 기록을 위한 장치였다. 민원이 들어오면 다시 듣고, 법으로 남겨야 하는 통화를 보관하는 장치. 인공지능 컨택센터에서 녹취는 하나의 역할을 더 맡는다. 상담사 옆자리와 뒷자리의 인공지능에게 소리를 넘기는 공급원이다.
왜 교환기가 아니라 녹취인가? 교환기는 전화를 연결하는 장치라 소리를 밖으로 내주는 일에 서툴다. 녹취는 처음부터 소리를 복사하려고 만든 장치다. 이미 고객 쪽 소리와 상담사 쪽 소리를 따로 받고 있다. 두 사람이 동시에 말해도 누가 한 말인지 갈라지는 이유이고, 이것을 화자 분리라고 부른다. 화자 분리가 안 된 녹취로는 뒤의 분석이 절반밖에 안 된다. 상담사가 필수 안내를 했는지 보려면 상담사쪽 소리가 따로 있어야 하기 때문이다. 녹취를 쓸 수 없는 센터에서는 네트워크 스위치에서 소리를 복사하는 장비를 따로 두기도 하지만, 통화가 암호화되어 있으면 그 길은 막힌다. 어느 쪽이든 원칙은 같다. 상담사 옆자리와 뒷자리는 녹취가 없으면 성립하지 않는다.
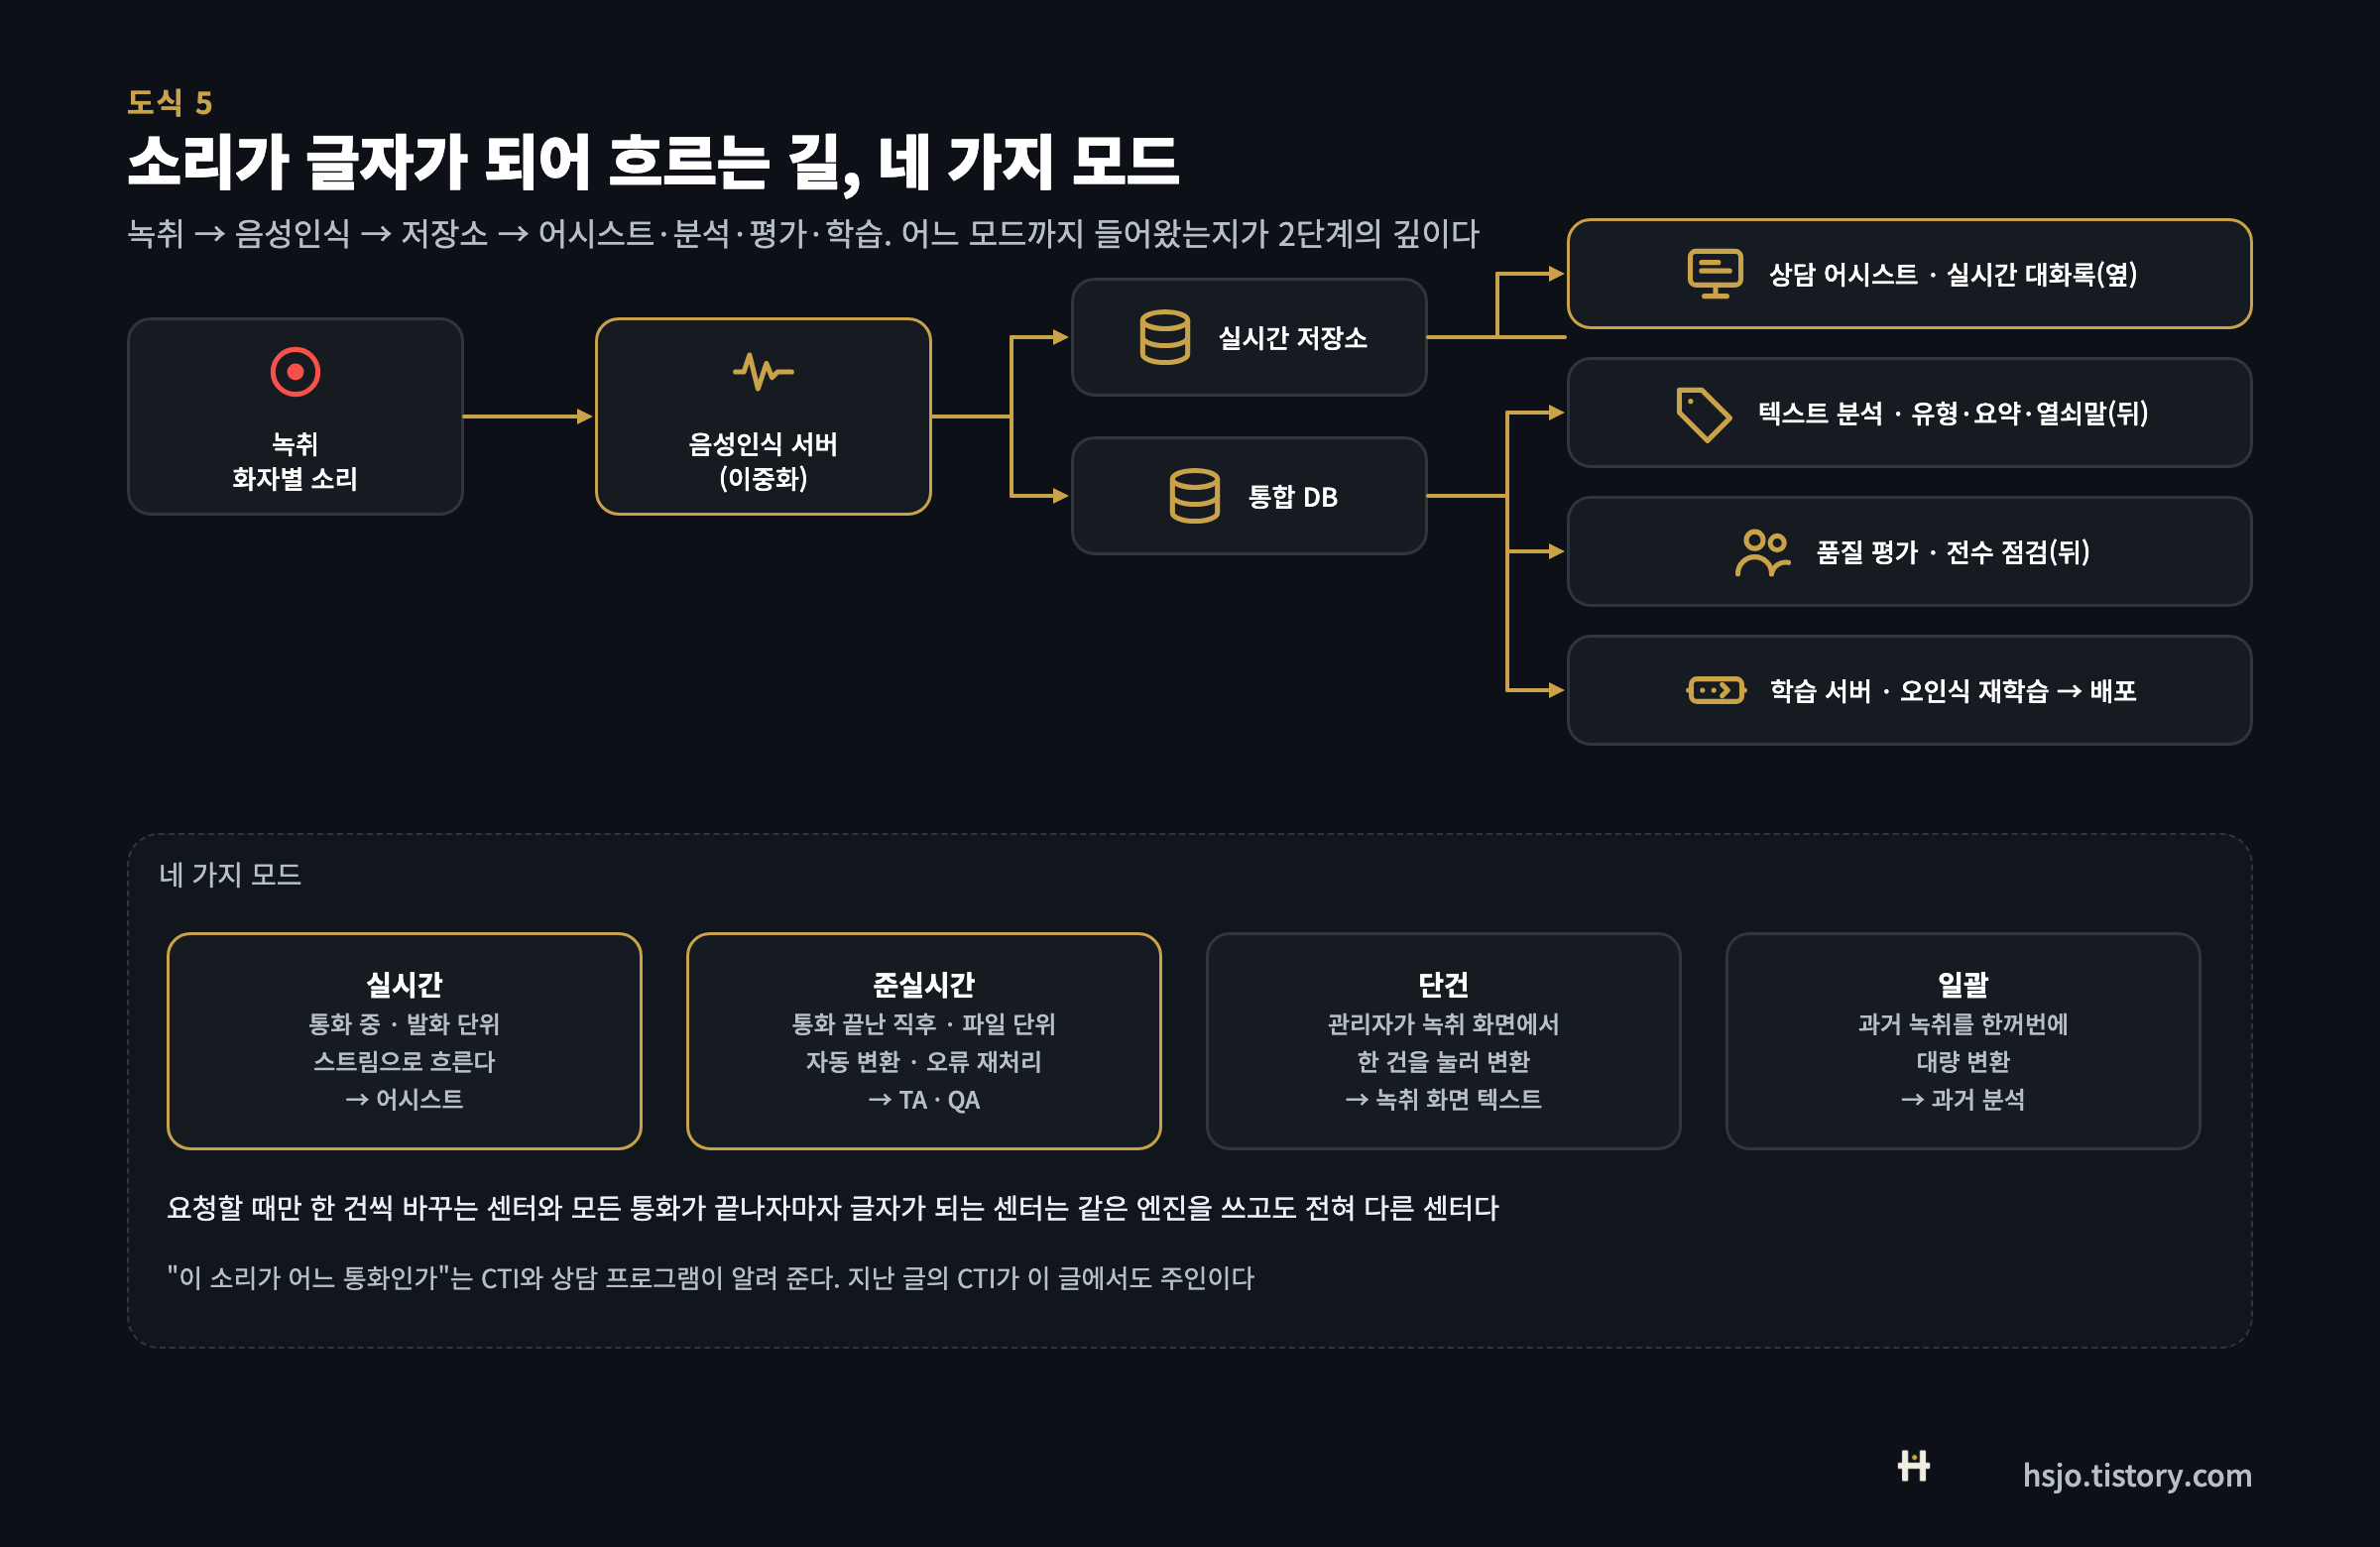
녹취에서 나온 소리가 글자가 되어 어디로 가는지를 한 줄로 그리면 이렇다. 녹취가 화자별 소리를 음성인식에 넘긴다. 음성인식이 글자로 바꾼다. 글자는 두 곳에 놓인다. 실시간 저장소와 통합 데이터베이스. 실시간 저장소의 글자는 상담 어시스트가 바로 가져가 화면에 올리고, 통합 데이터베이스의 글자는 텍스트 분석과 품질 평가가 통화가 끝난 뒤 가져간다. 음성인식이 틀린 말은 따로 모아 학습 서버로 보내고, 다시 배운 모델을 일하는 서버에 올린다. 이 한 줄에 모드가 넷 있다. 통화 중에 발화 단위로 흐르는 실시간, 통화가 끝난 뒤 파일 단위로 바꾸는 준실시간, 관리자가 녹취 화면에서 한 건을 눌러 바꾸는 단건, 과거 녹취를 한꺼번에 바꾸는 일괄. 센터가 "음성인식을 넣었다"고 할 때 네 모드 중 어디까지 들어왔는지가 그 센터의 깊이다. 요청할 때만 한 건씩 바꾸는 센터와, 모든 통화가 끝나자마자 글자가 되는 센터는 같은 엔진을 쓰고도 전혀 다른 센터다.
여기서 한 가지가 따라온다. 통화가 언제 시작되고 끝났는지를 누가 알려 주는가다. 녹취와 음성인식은 소리만 받지 전화의 사정을 모른다. "이 소리가 어느 통화의 것인지, 상담사가 받은 순간이 언제인지"는 CTI와 상담 프로그램이 알려 준다. 이 신호가 어긋나면 상담사가 받기 전의 통화 연결음이 글자로 찍히거나, 녹취와 글자의 시각이 몇 초 어긋난다. 전화의 사정을 아는 것은 CTI뿐이라, 인공지능이 들어와도 통화의 주인은 여전히 CTI다.
마무리
재료를 요소보다 먼저 말하게 된 것은 요소의 이름으로 설명하다 막힌 뒤부터다. 상담 어시스트가 무엇이냐는 질문에 화면의 기능을 나열하면 듣는 사람은 끝까지 블랙박스를 보고 있다. 음성인식이 문장 단위로 글자를 올리고, 자연어 처리가 그 글자에서 열쇠말을 뽑고, 그 소리는 녹취가 복사해 준 것이라고 말하면 그제야 그림이 선다. 그래서 지금은 순서를 바꿔 말한다. 엔진은 센터 하나에 하나이고, 그 엔진에 그 센터의 말을 가르치는 일과 소리를 끊기지 않게 대 주는 일이 요소 열 개를 받치고 있다. 봇을 고르는 일은 그다음이다.
다음 글은 이 재료가 상담사 옆과 뒤에서 실제로 하는 일이다. 상담사의 한 통을 여섯 칸으로 나누고, 통화 중에 받아 적고 찾아 주는 상담 어시스트, 통화 뒤에서 요약하고 분류하고 점수를 매기는 텍스트 분석과 품질 평가를 본다. 상담사를 돕는 인공지능이 어디를 돕는지가 거기서 보인다.
'tech' 카테고리의 다른 글
| 보이스봇은 상담사에게 가지 않아도 되는 전화를 그 앞에서 끝낸다 (0) | 2026.10.13 |
|---|---|
| 상담사는 통화만 하고 받아쓰기와 찾기와 정리는 인공지능이 맡는다 (0) | 2026.10.13 |
| 인공지능은 컨택센터 어디에서 상담사를 돕는가, AICC란 무엇인가 (0) | 2026.10.11 |
| 전화는 어떻게 컨택센터 시스템에 연결되는가, IPCC 여섯 단계로 따라가는 전화의 길 (0) | 2026.10.10 |
| 프롬프트를 GitHub에 기록하며 일하는 법, 대화가 끝나도 맥락은 남는다 (2) | 2026.10.07 |