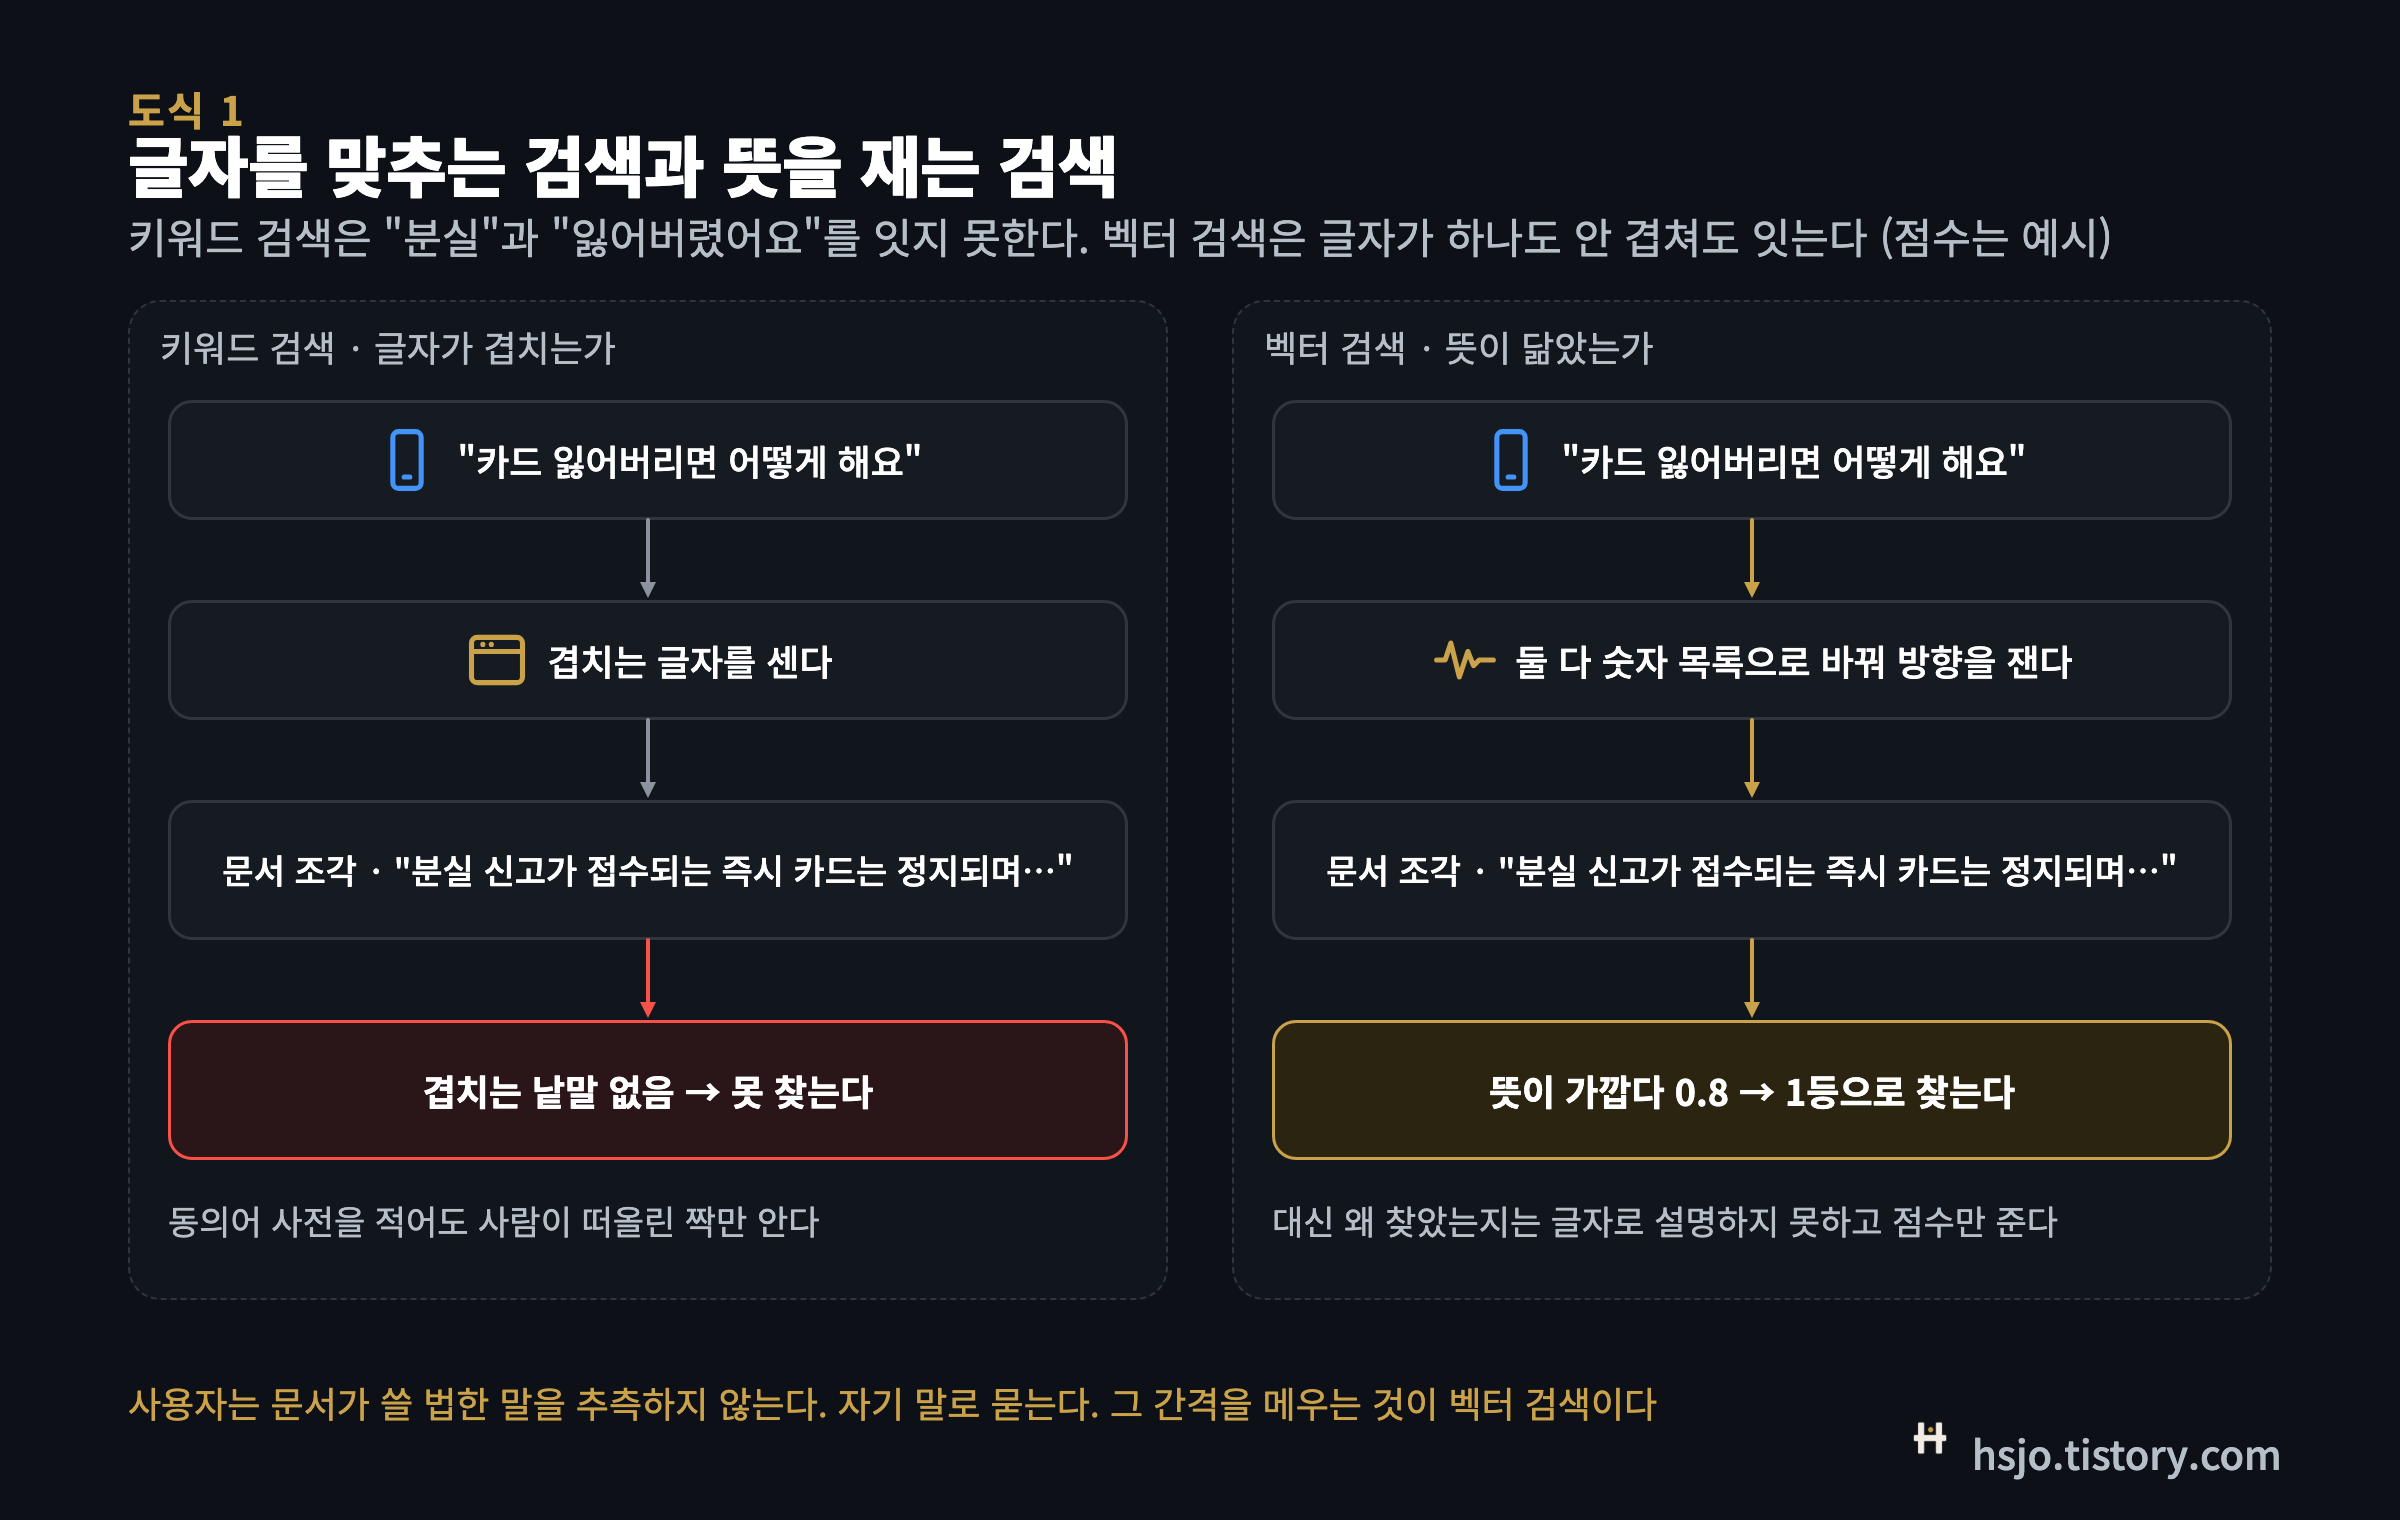
사내 규정을 찾는 검색창에 "카드 잃어버리면 어떻게 해요"라고 친다. 결과가 없다. 문서에는 "분실"이라고 적혀 있기 때문이다. 글자를 맞추는 검색은 "잃어버리다"와 "분실"이 같은 뜻이라는 것을 모른다. 그래서 사람은 검색창 앞에서 문서가 쓸 법한 말을 추측한다. 봇은 그 추측을 사용자에게 시킬 수 없다. 사용자는 자기 말로 묻는다. 내가 만든 챗봇 시스템에 "카드 분실 신고 안내"라는 가상의 규정 문서를 올리고 "카드 잃어버리면 어떻게 해요"라고 물으면, 글자는 하나도 겹치지 않는데 그 문서의 첫 대목이 1등으로 올라온다. 문장을 숫자로 바꾸고, 숫자끼리 닮은 정도를 재서 찾기 때문이다. 이 글은 그 두 가지, 벡터화와 벡터 검색을 신입사원이 따라올 수 있는 속도로 적는다.
지난 글에서 RAG의 묻는 길은 질문과 닮은 조각을 찾아 모델에게 건네는 길이었다. 그 "닮은 조각을 찾는" 자리가 이 글이다. 조각을 숫자로 바꾸는 임베딩이 무엇인지, 닮음을 어떻게 재는지, 저장된 수천 개 중에서 어떻게 골라내는지, 그리고 내 시스템에서 이것이 지식 검색 말고 어디에 또 쓰이는지를 본다.
글자를 맞추는 검색이 못하는 것
검색의 오래된 방식은 글자를 맞추는 것이다. 질문에 든 낱말이 문서에 있으면 찾고 없으면 못 찾는다. 키워드 검색(keyword search)이라 부른다. 빠르고 설명하기 쉽다. "분실"로 찾았으니 "분실"이 든 문서가 나온다. 그런데 사람의 말은 같은 뜻을 여러 모양으로 쓴다. 잃어버렸다, 분실했다, 없어졌다, 안 보인다. 문서는 그중 하나로 적혀 있고 사용자는 다른 하나로 묻는다. 동의어 사전을 만들어 "잃어버리다 = 분실"을 적어 두면 풀리지만, 사전은 사람이 생각해 낸 짝만 안다. "카드가 어디 갔는지 모르겠어요"는 어느 사전에도 없다. 한국어는 어미와 조사가 붙어 글자 모양이 더 자주 바뀐다. "잃어버렸어요", "잃어버린", "잃어버리면"이 글자로는 다 다르다.
| 구분 | 키워드 검색 | 벡터 검색 |
| 무엇을 비교하나 | 글자가 겹치는가 | 뜻이 닮았는가 |
| "분실"과 "잃어버렸어요" | 못 잇는다 | 잇는다 |
| 왜 찾았는지 | 겹친 낱말을 보여 줄 수 있다 | 점수만 준다 |
| 준비물 | 색인 | 임베딩 모델과 벡터 저장소 |
뜻을 재는 검색은 반대로 간다. 문장을 글자가 아니라 뜻의 자리로 바꿔 두고, 자리가 가까운 것을 찾는다. 의미 검색(semantic search)이라고도 부르고, 그 자리를 숫자로 적은 것이 벡터라서 벡터 검색(vector search)이라고도 부른다. 글자가 하나도 안 겹쳐도 찾고, 대신 왜 찾았는지를 글자로 설명하지 못한다. 점수 하나를 돌려줄 뿐이다. 이 차이가 뒤에서 운영 이야기로 이어진다.
문장을 숫자로 바꾼다, 벡터화
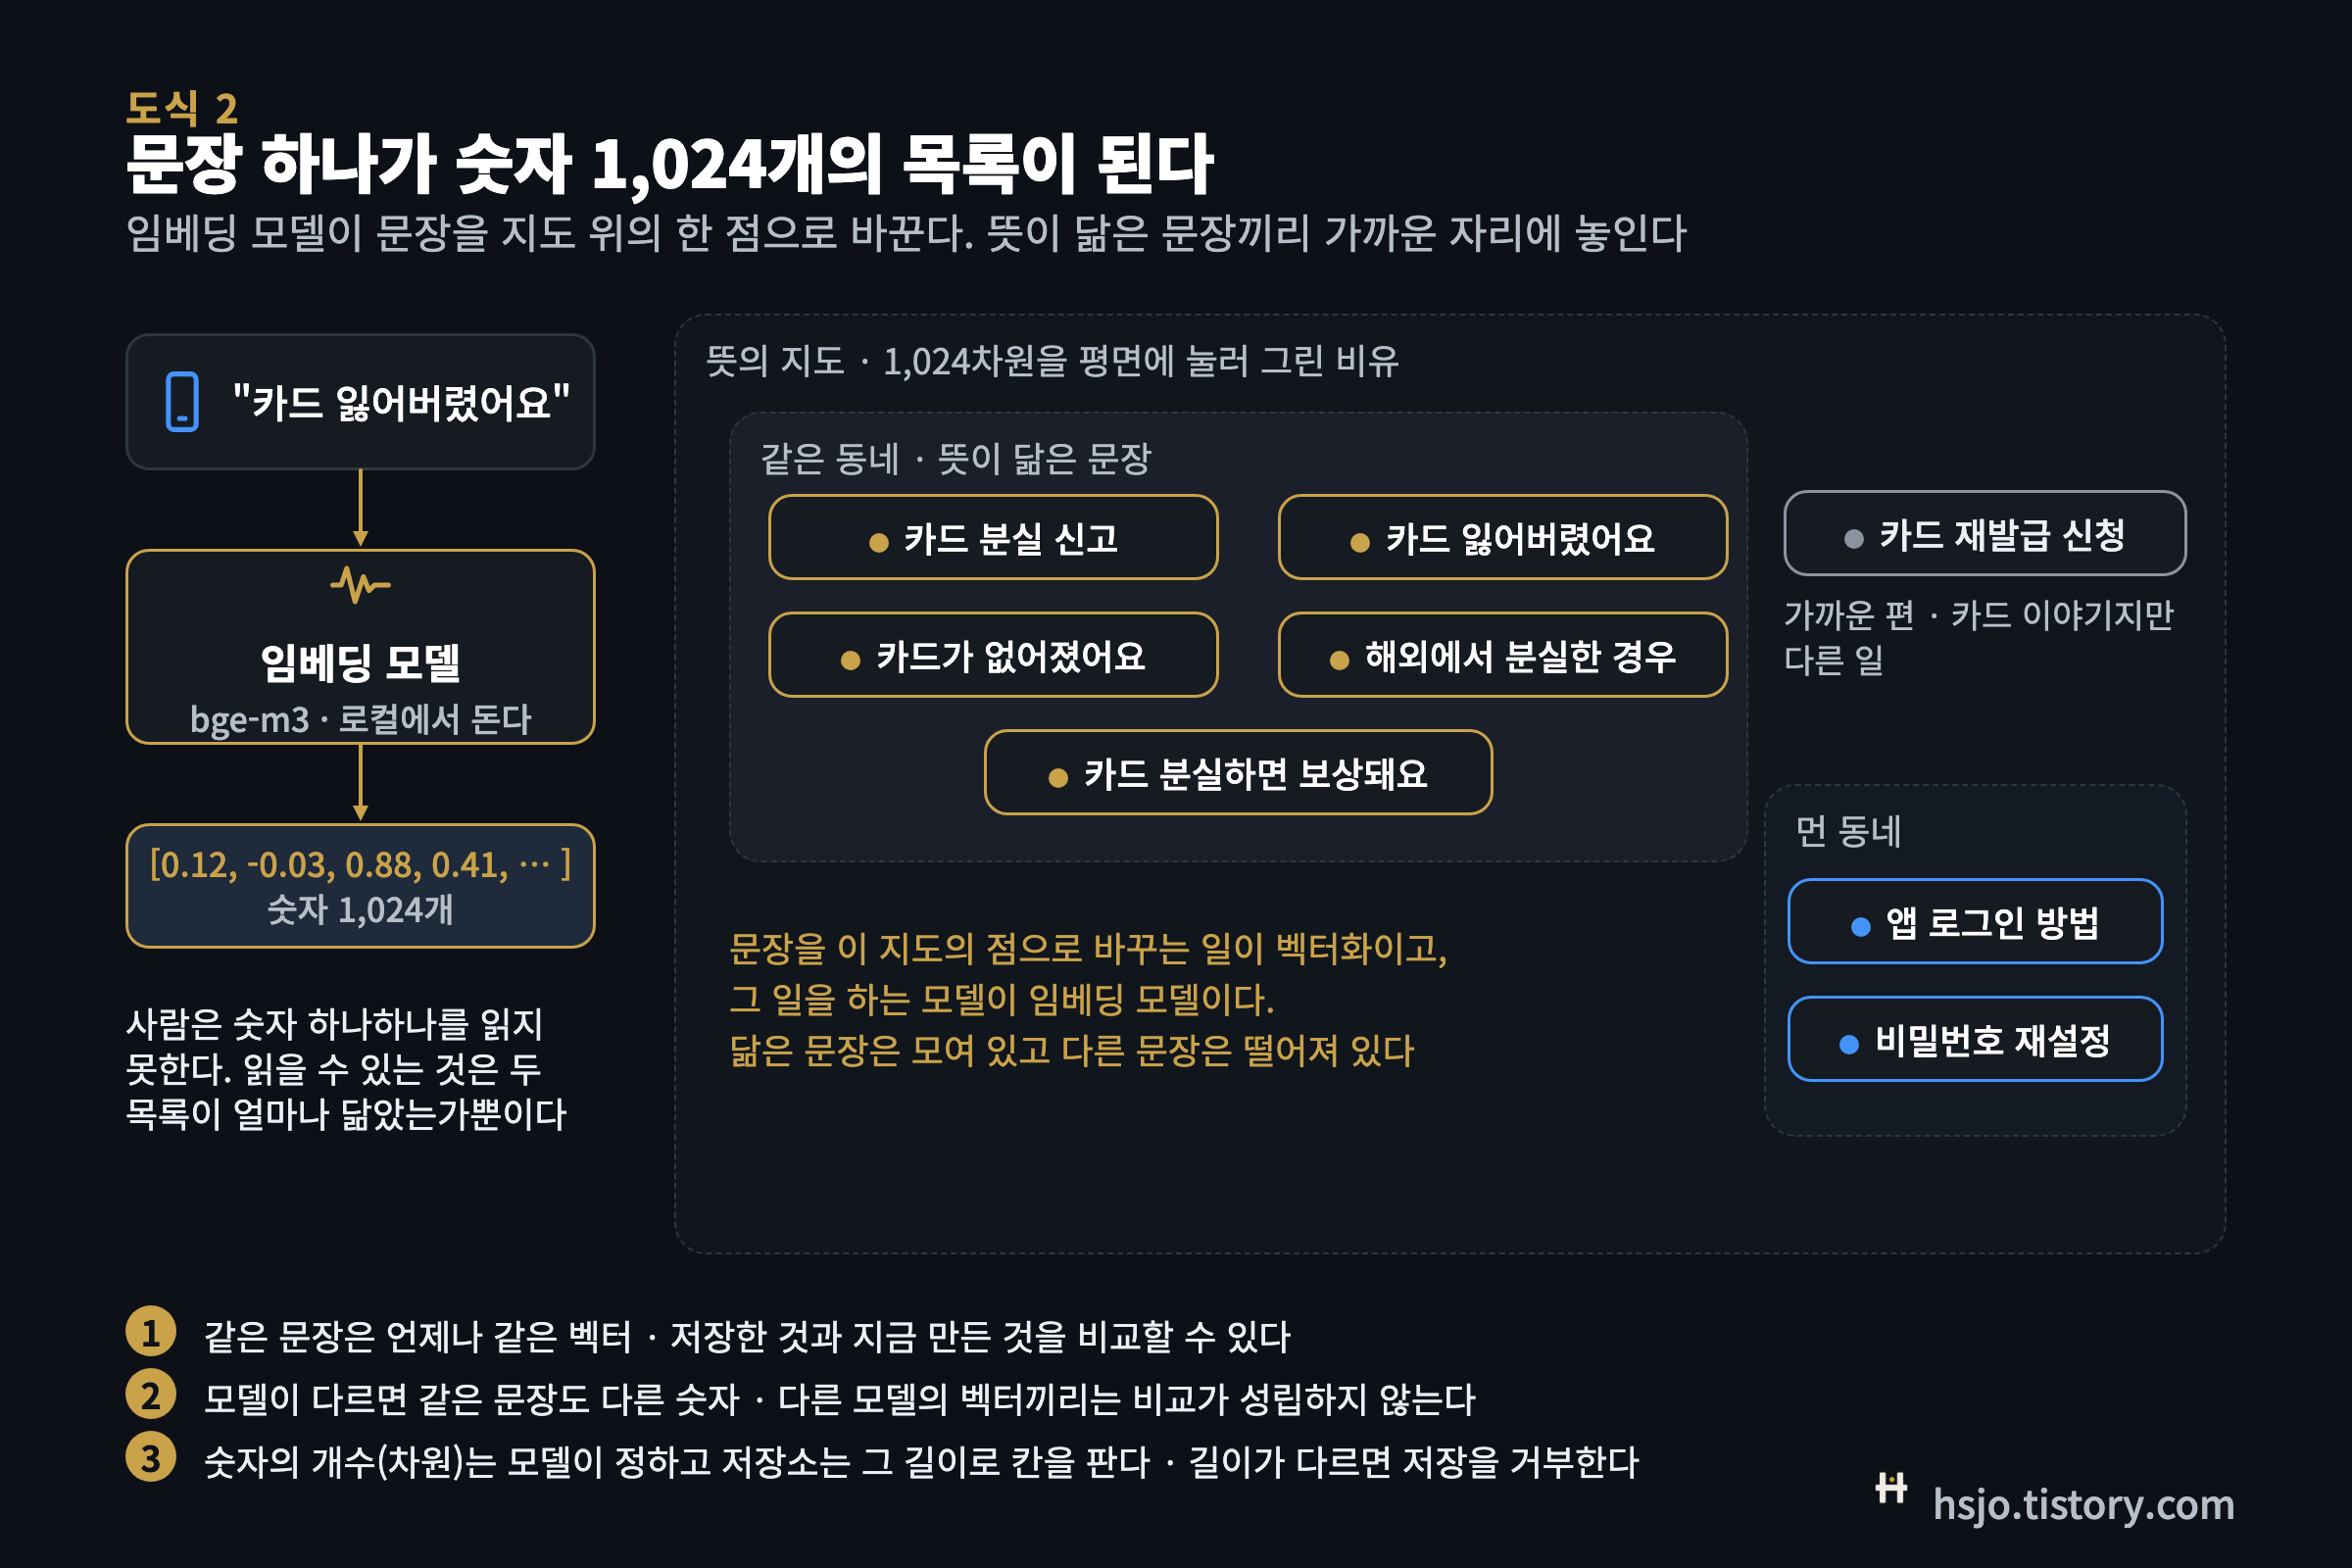
벡터(vector)는 숫자를 줄 세운 목록이다. 지도 위의 한 점을 가로 숫자와 세로 숫자 둘로 적듯, 문장 하나를 숫자 여러 개로 적은 것이다. 내 시스템의 임베딩 모델은 문장 하나를 숫자 1,024개로 바꾼다. 숫자 하나하나가 무엇을 뜻하는지는 사람이 읽을 수 없다. 읽을 수 있는 것은 두 목록이 얼마나 닮았는가뿐이다. 그런데 그것으로 충분하다. 임베딩 모델은 엄청난 양의 글을 읽으며 "같은 자리에 올 수 있는 말은 뜻이 비슷하다"는 쪽으로 숫자를 맞춰 온 모델이라, 뜻이 비슷한 문장은 비슷한 숫자 목록이 나온다. 지도에 비유하면 "카드 분실 신고"와 "카드 잃어버렸어요"는 같은 동네에 찍히고, "앱 로그인 방법"은 먼 동네에 찍힌다. 문장을 이 지도 위의 점으로 바꾸는 일이 벡터화이고, 그 일을 하는 모델이 임베딩 모델(embedding model)이다.
세 가지 성질이 뒤의 모든 것을 떠받친다. 첫째, 같은 문장은 언제나 같은 벡터다. 그래서 저장해 둔 벡터와 지금 만든 벡터를 비교할 수 있다. 둘째, 모델이 다르면 같은 문장이라도 다른 숫자가 나온다. 다른 모델로 만든 벡터끼리는 같은 지도 위에 있지 않아 비교가 성립하지 않는다. 그래서 임베딩 모델을 바꾸면 저장해 둔 벡터를 전부 다시 만들어야 하고, 내 시스템은 벡터를 저장할 때 몇 차원인지를 함께 적어 둔다. 셋째, 벡터의 길이, 곧 숫자의 개수는 모델이 정하고 저장소는 그 길이로 칸을 판다. 내 시스템의 칸은 1,024개이고, 다른 길이의 벡터가 들어오면 저장을 거부하고 "임베딩 모델 설정을 확인하라"고 알린다. 조용히 받아 두면 나중에 비교가 전부 틀리기 때문이다.
내 시스템이 쓰는 임베딩 모델은 bge-m3다. 폐쇄망에서도 돌아야 해서 로컬 모델이어야 했고, 한국어 검색 품질이 확인된 것 중에서 골랐다. 대화 모델은 인터넷 API와 로컬 모델을 스위치로 바꾸지만 임베딩 모델은 바꾸지 않는다. 둘째 성질 때문이다.
닮음을 재는 자, 코사인 유사도
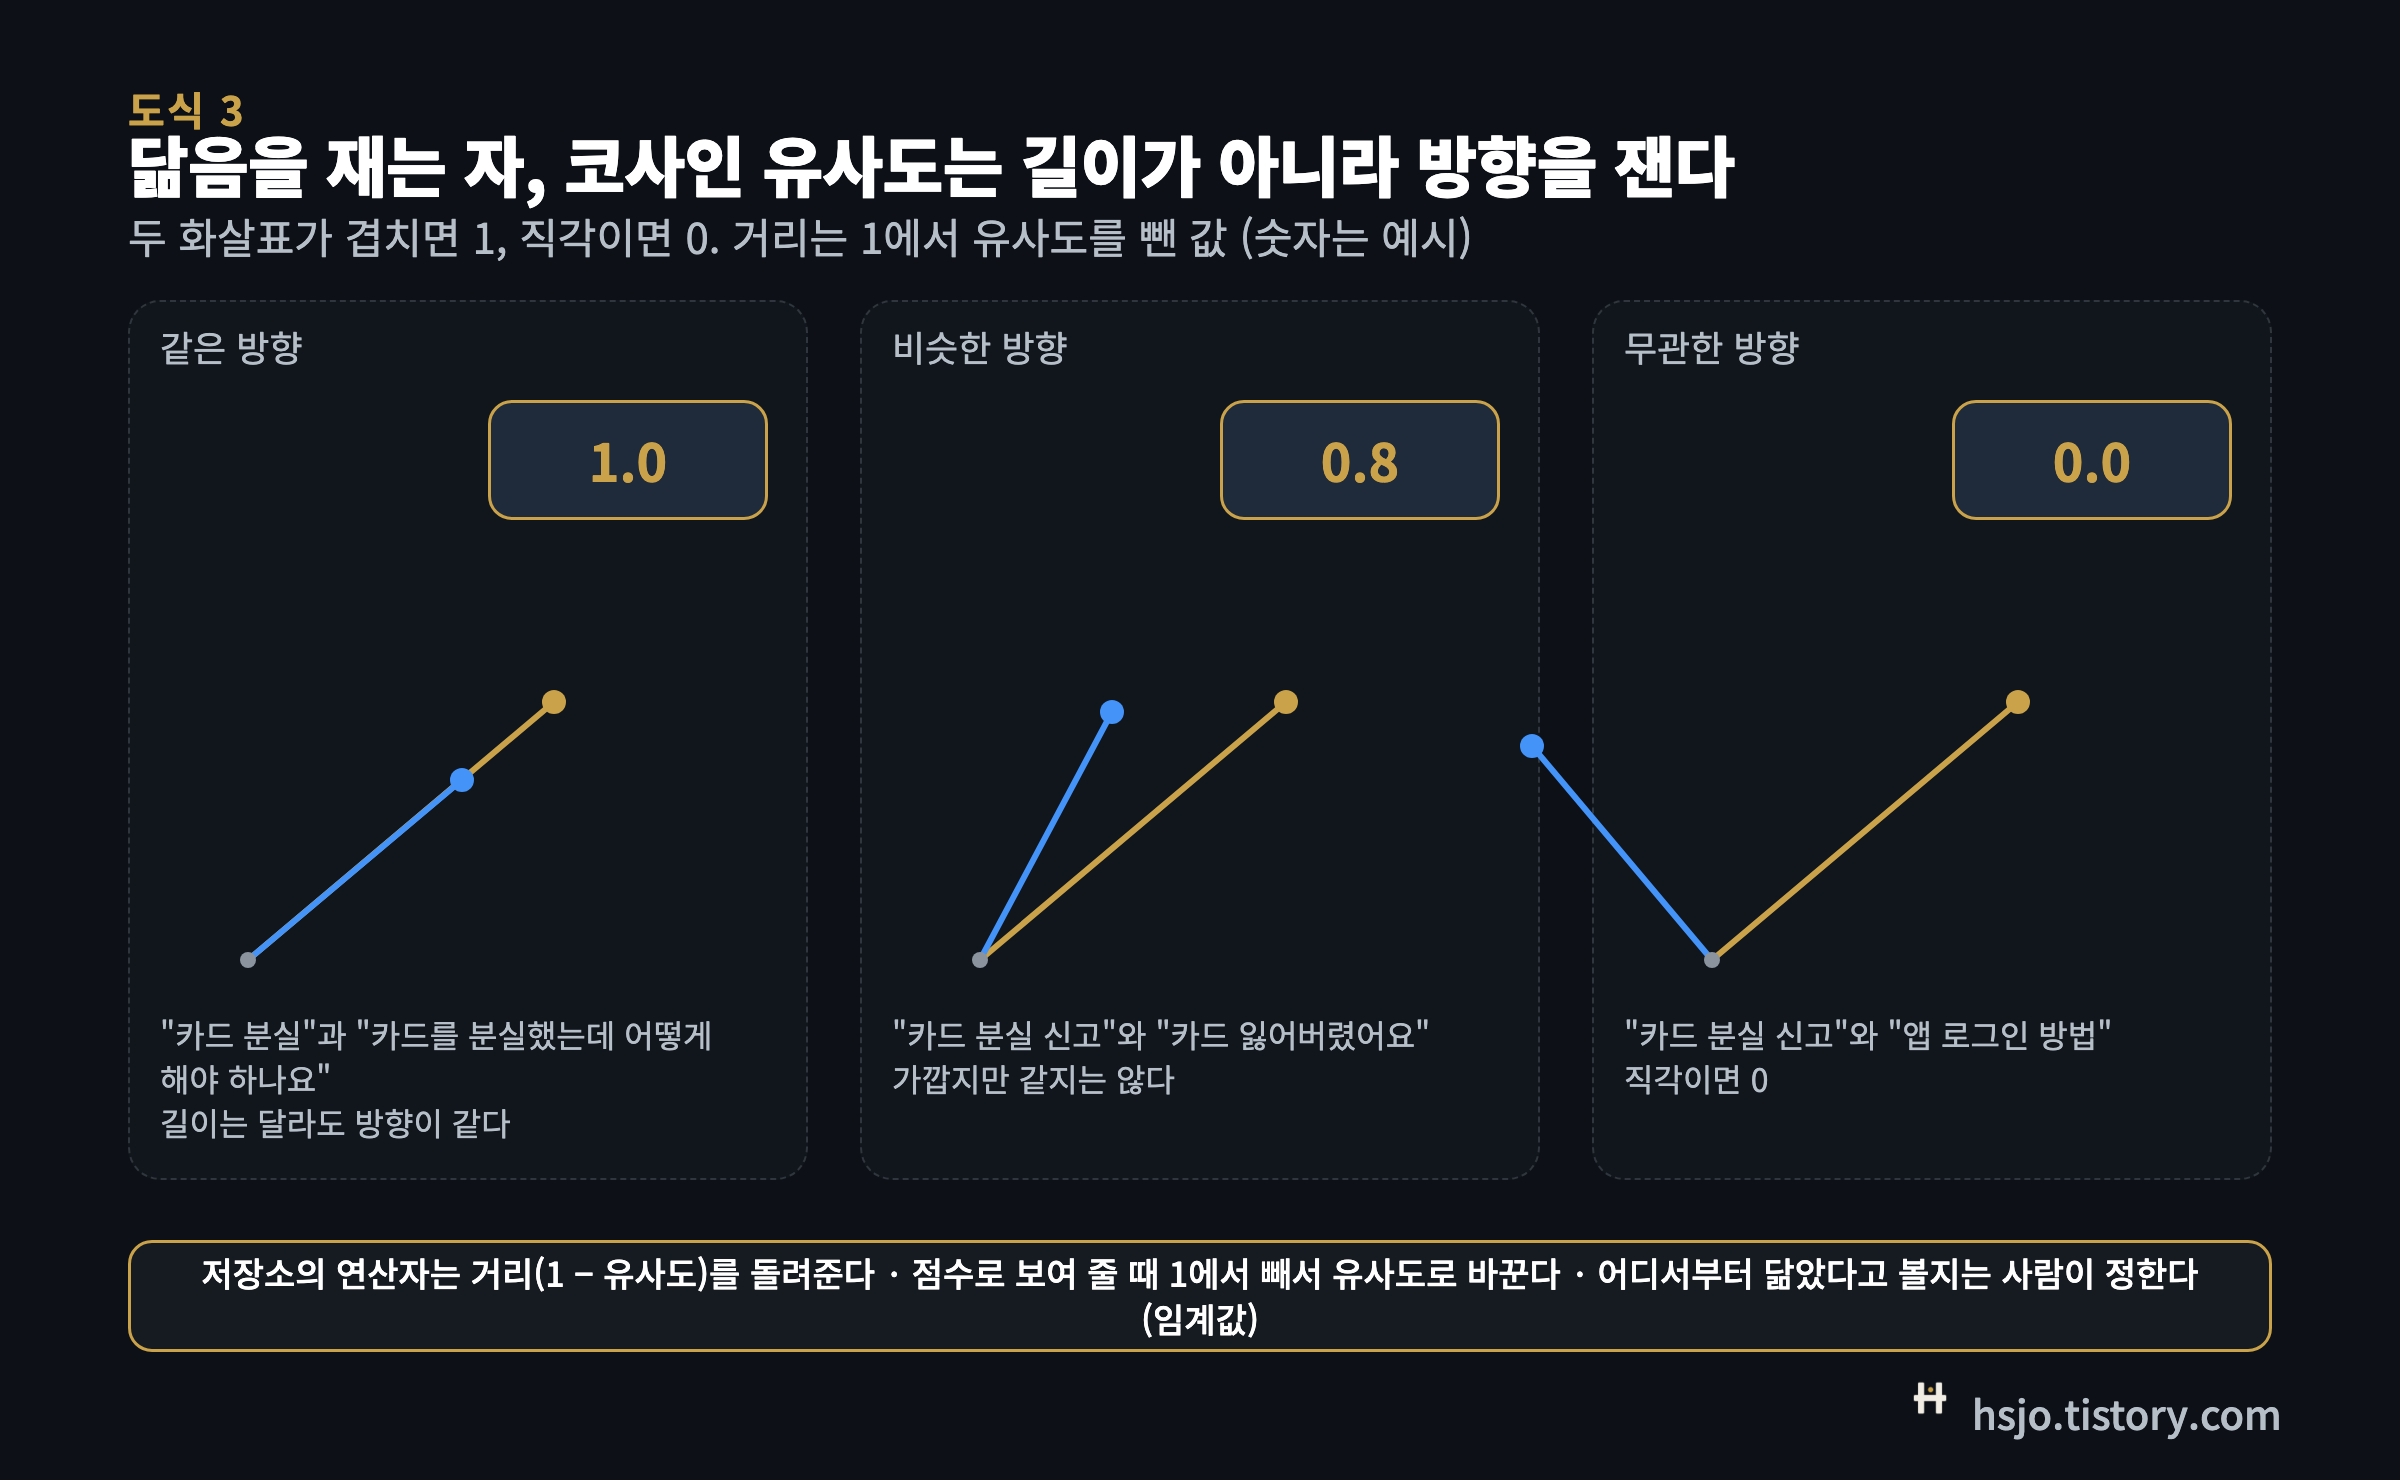
두 벡터가 닮았는지를 재는 자가 코사인 유사도(cosine similarity)다. 두 점 사이의 거리를 재는 것이 아니라 두 화살표가 얼마나 같은 방향을 보는지를 잰다. 원점에서 각 점으로 화살표를 그었을 때 두 화살표가 겹치면 1, 직각이면 0이다. 길이를 재지 않는 이유는 문장의 길이나 표현의 세기가 벡터의 길이로 새기 때문이다. "카드 분실"과 "카드를 분실했는데 어떻게 해야 하나요"는 화살표 길이는 달라도 방향은 거의 같다. 방향만 보면 둘이 닮았다고 나온다.
내 시스템은 벡터를 PostgreSQL의 pgvector 확장에 저장하고, 그 확장이 주는 코사인 연산자를 그대로 쓴다. 이 연산자는 유사도가 아니라 거리를 돌려준다. 거리는 1에서 유사도를 뺀 값이라, 같은 방향이면 0, 무관하면 1이다. 그래서 점수로 보여 줄 때는 1에서 거리를 빼서 유사도로 바꾼다. 같은 문장이면 1.0, 뜻이 가까우면 0.8 언저리, 무관하면 0 근처다. 이 숫자들은 예시이고, 실제 값은 모델과 문장에 따라 다르다. 중요한 것은 점수가 "맞다·틀리다"가 아니라 "얼마나 닮았나"라는 연속된 값이라는 점이다. 어디서부터 닮았다고 볼지는 사람이 정한다. 그것이 뒤에 나오는 임계값이다.
찾는 법, 거리 순으로 줄을 세운다
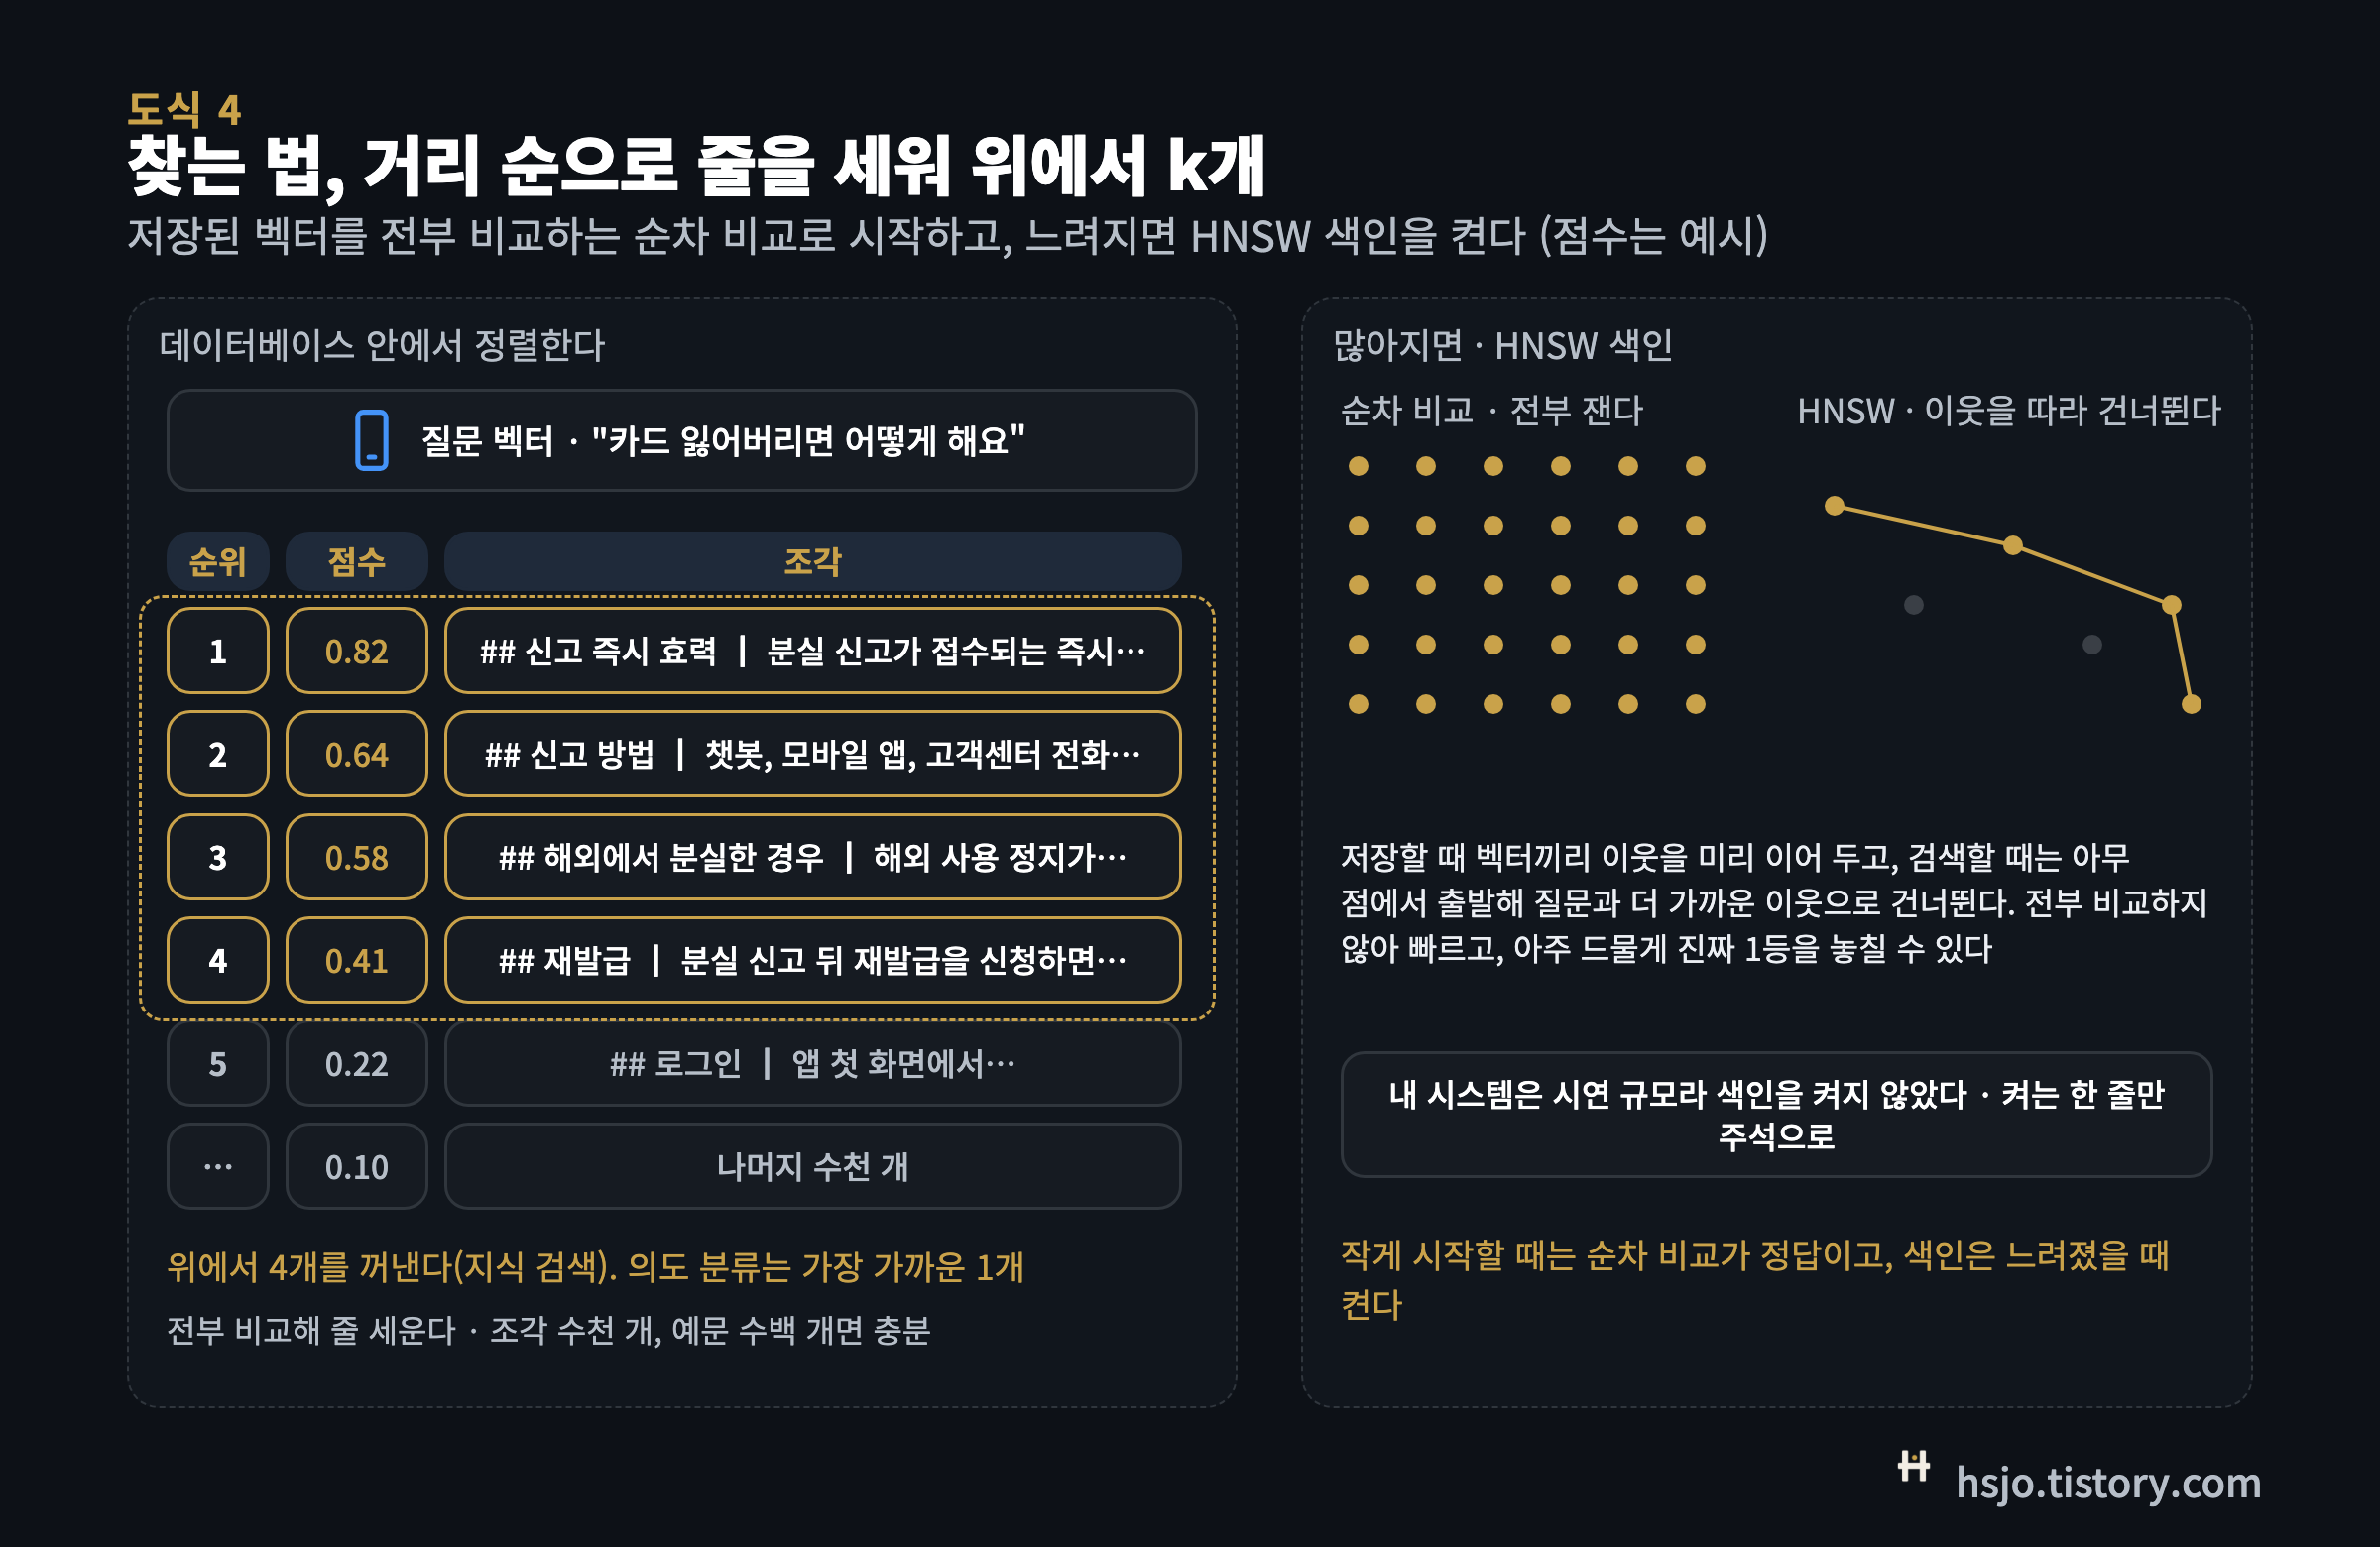
벡터 검색은 결국 줄 세우기다. 질문을 벡터로 바꾸고, 저장된 벡터 하나하나와의 거리를 재고, 가까운 순으로 정렬해 위에서 k개를 꺼낸다. 내 시스템은 이 정렬을 데이터베이스 안에서 한다. 벡터를 밖으로 꺼내 비교하지 않고, 데이터베이스에 "이 벡터와 가까운 순으로 정렬해 위에서 넷"이라고 묻는다. 지식 검색은 넷, 의도 분류는 가장 가까운 하나를 가져온다.
저장된 벡터를 전부 비교하는 방식을 순차 비교라 한다. 조각 수천 개, 예문 수백 개 규모에서는 이것으로 충분하다. 수십만, 수백만으로 늘어나면 전부 비교하는 시간이 느껴지기 시작한다. 그때 켜는 것이 HNSW(계층 탐색 그래프, hierarchical navigable small world) 색인이다. 저장할 때 벡터끼리 "이웃"을 미리 이어 두고, 검색할 때는 아무 점에서 출발해 질문과 더 가까운 이웃으로 건너뛰며 근처만 보는 방식이다. 전부 비교하지 않으므로 빠르고, 대신 아주 드물게 진짜 1등을 놓칠 수 있다. 내 시스템은 시연 규모라 색인을 켜지 않았고, 켜는 한 줄만 주석으로 적어 두었다. 작게 시작할 때는 순차 비교가 정답이고, 색인은 느려졌을 때 켜는 것이다.
쓰임 하나, 지식 검색
지난 글의 묻는 길이 이 줄 세우기다. 문서를 조각으로 나눠 조각마다 벡터를 저장해 두고, 질문 벡터와 가까운 조각 넷을 꺼내 출처를 붙여 모델에게 건넨다. 도입의 장면이 그것이다. "카드 잃어버리면 어떻게 해요"의 벡터는 "분실 신고가 접수되는 즉시 카드는 정지되며"라는 조각의 벡터와 가깝다. 글자는 겹치지 않는데 자리가 가깝다. 이 글에서는 여기까지만 잇고, 같은 줄 세우기가 다른 데도 쓰인다는 쪽으로 간다.
쓰임 둘, 버튼 대신 말로 들어오는 의도 분류
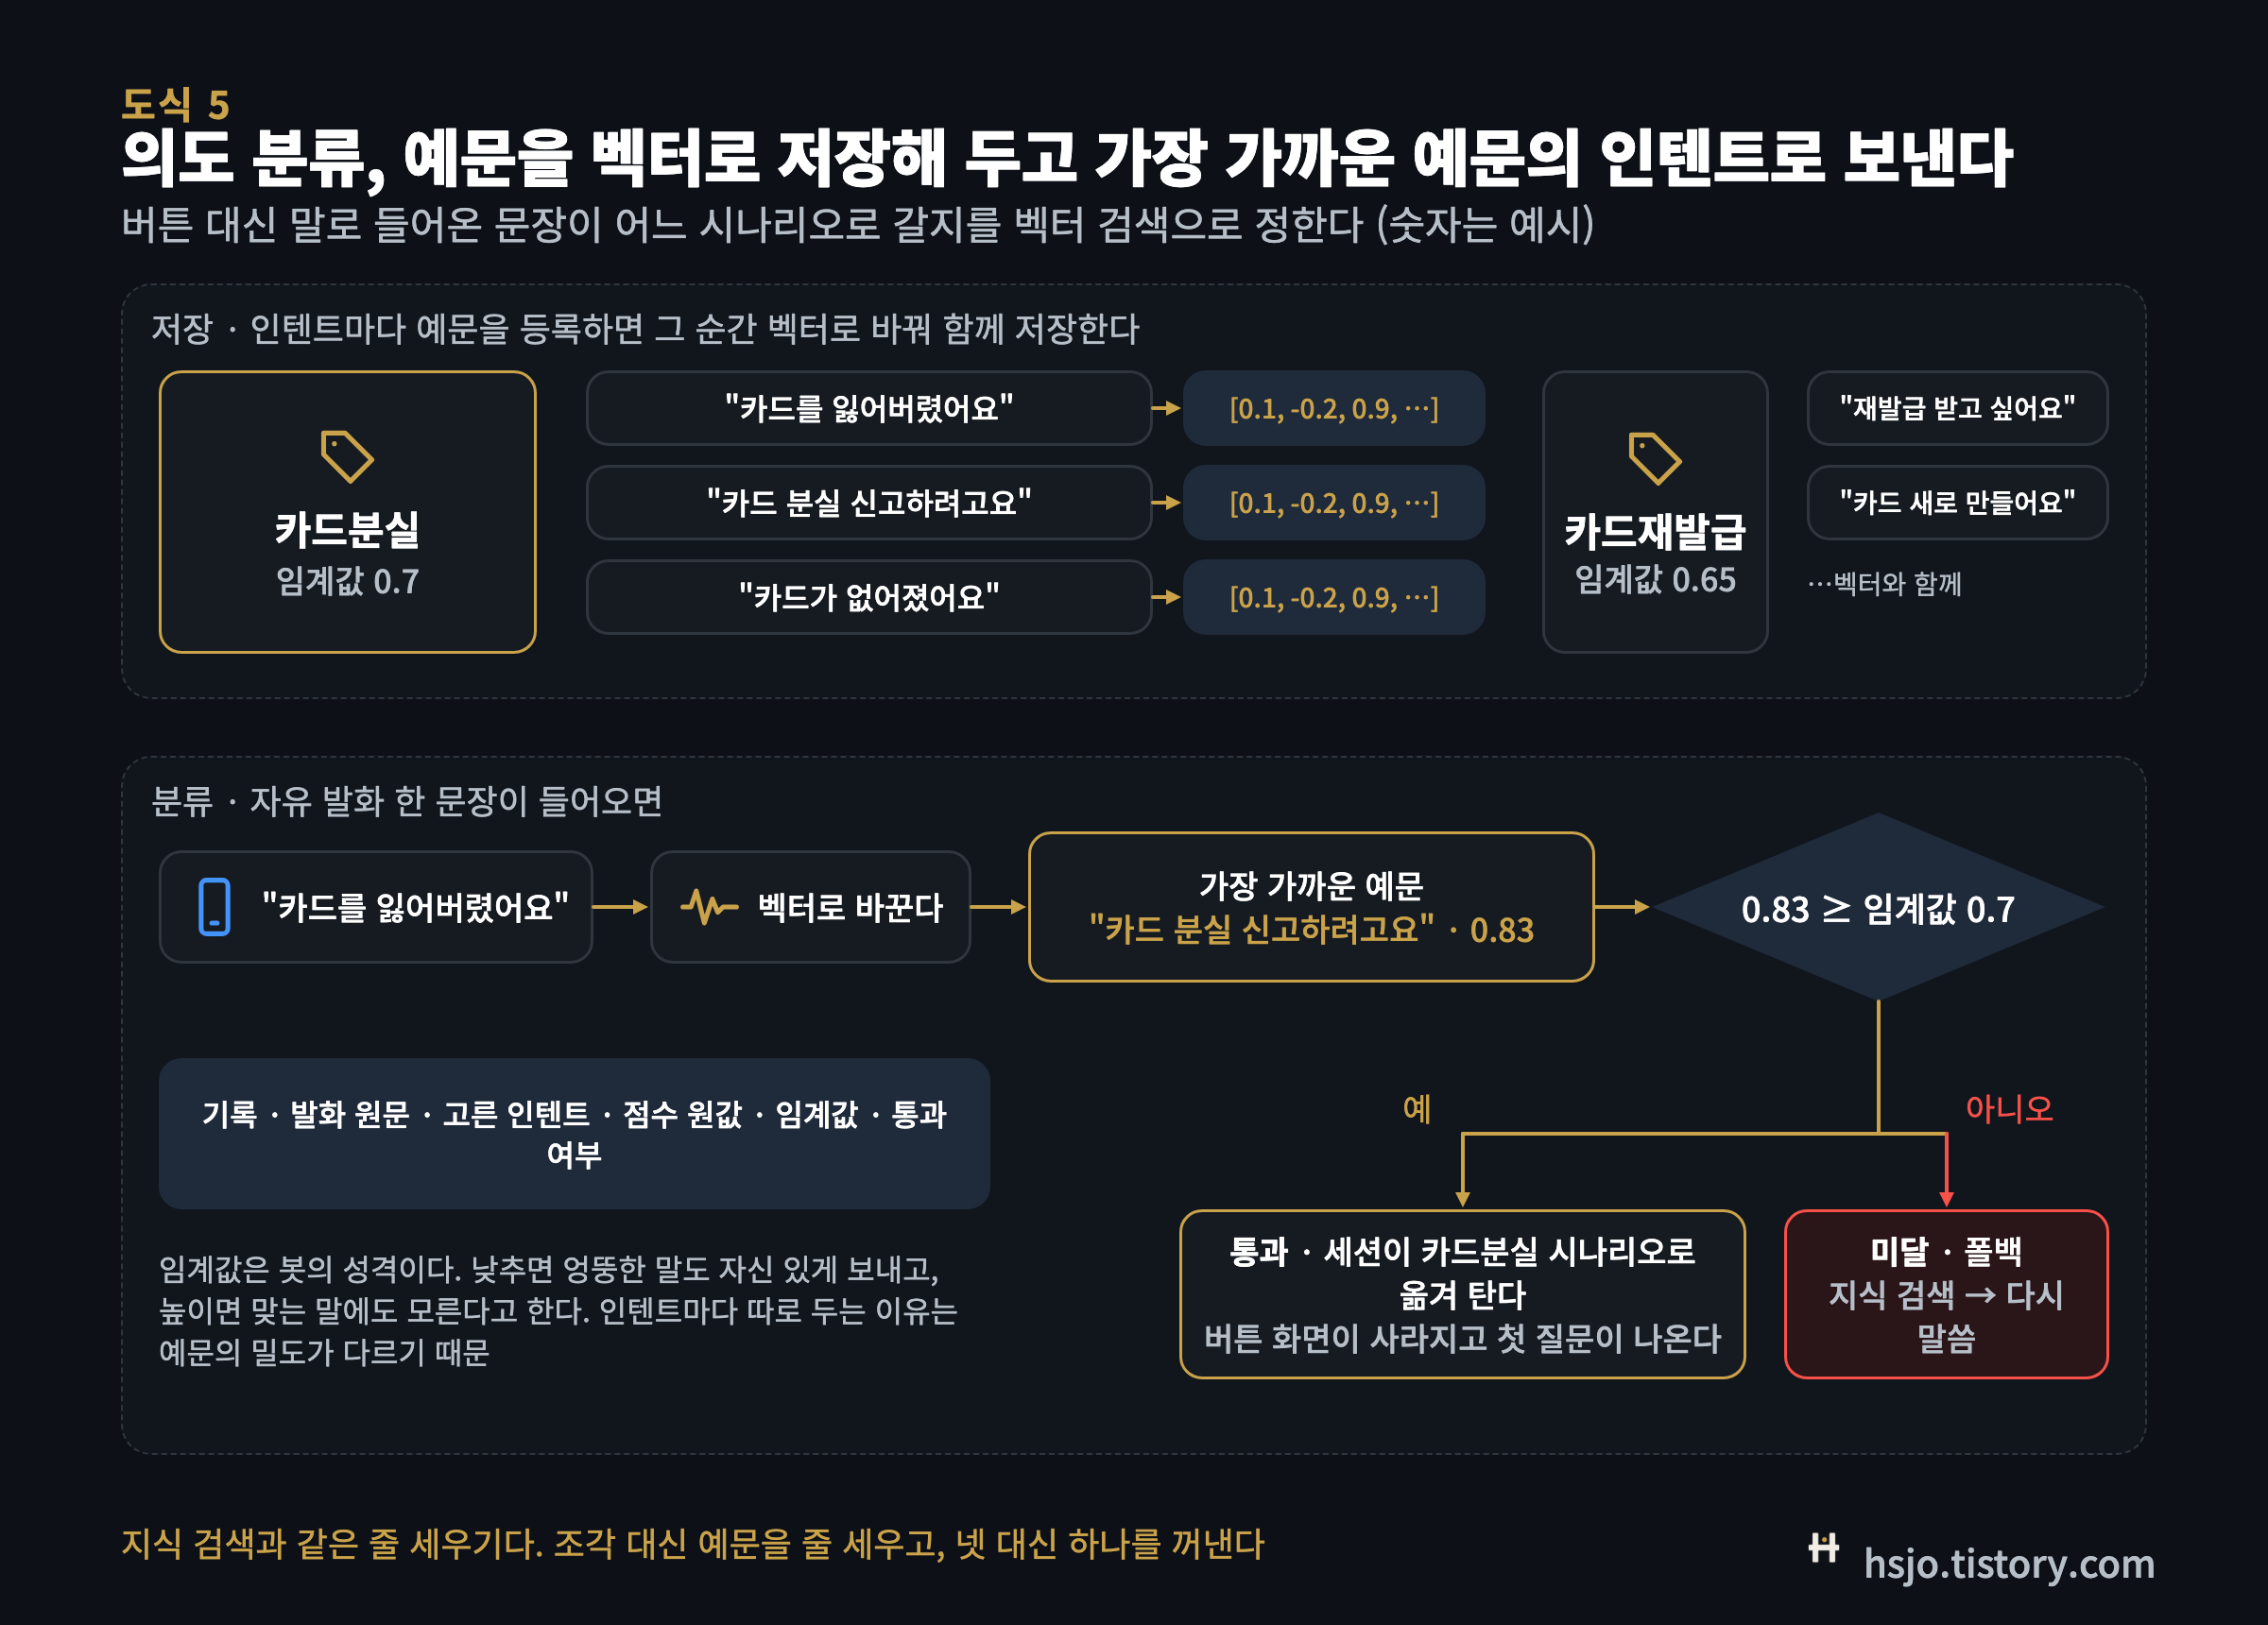
봇은 버튼으로 시작한다. 사용자가 버튼 대신 "카드를 잃어버렸어요"라고 치면, 봇은 그 말이 어느 시나리오로 가야 하는지 정해야 한다. 이것이 의도 분류이고, 인텐트(의도, intent)라는 말은 용어글에 있다. 내 시스템은 이 분류를 벡터 검색으로 한다. 인텐트마다 예시 발화를 몇 개 등록한다. "카드를 잃어버렸어요", "카드 분실 신고하려고요", "카드가 없어졌어요"를 카드분실 인텐트에 넣는 식이다. 등록하는 순간 각 예문을 벡터로 바꿔 함께 저장한다. 사용자가 자유 발화를 치면 그 문장을 벡터로 바꿔 저장된 모든 예문 중 가장 가까운 하나를 찾고, 그 예문이 속한 인텐트와 점수를 돌려준다. 설계 문서의 예시로는 "카드를 잃어버렸어요"가 카드분실의 한 예문과 0.83으로 가장 가깝다.
점수가 나왔다고 끝이 아니다. 인텐트마다 임계값(threshold)이 있다. 0에서 1 사이의 선이고, 점수가 그 선을 넘어야 "이 인텐트가 맞다"로 친다. 예시의 임계값이 0.7이면 0.83은 통과다. 통과하면 대화 세션이 그 인텐트의 시나리오로 옮겨 탄다. 사용자가 보던 버튼 화면이 사라지고 카드분실 시나리오의 첫 질문이 나온다. 미달이면 지난 글에서 본 폴백으로 간다. 지식을 한 번 검색해 보고, 그것도 멀면 "다시 말씀해 주세요"다. 분류할 때마다 발화 원문, 고른 인텐트, 점수 원값, 임계값, 통과 여부를 이벤트로 남긴다. 예문이 하나도 없는 봇은 임베딩 계산 자체를 건너뛰고, 같은 예문을 다시 등록하면 조용히 건너뛴다.
임계값은 봇의 성격이다. 낮추면 엉뚱한 말도 어느 인텐트로 자신 있게 보내고, 높이면 맞는 말에도 모른다고 한다. 이 숫자를 인텐트마다 따로 두는 이유는 인텐트마다 예문의 밀도가 다르기 때문이다. 예문이 많고 표현이 고른 인텐트는 높은 선을 견디고, 예문이 적은 인텐트는 낮춰야 한다.
임계값을 정하는 상자
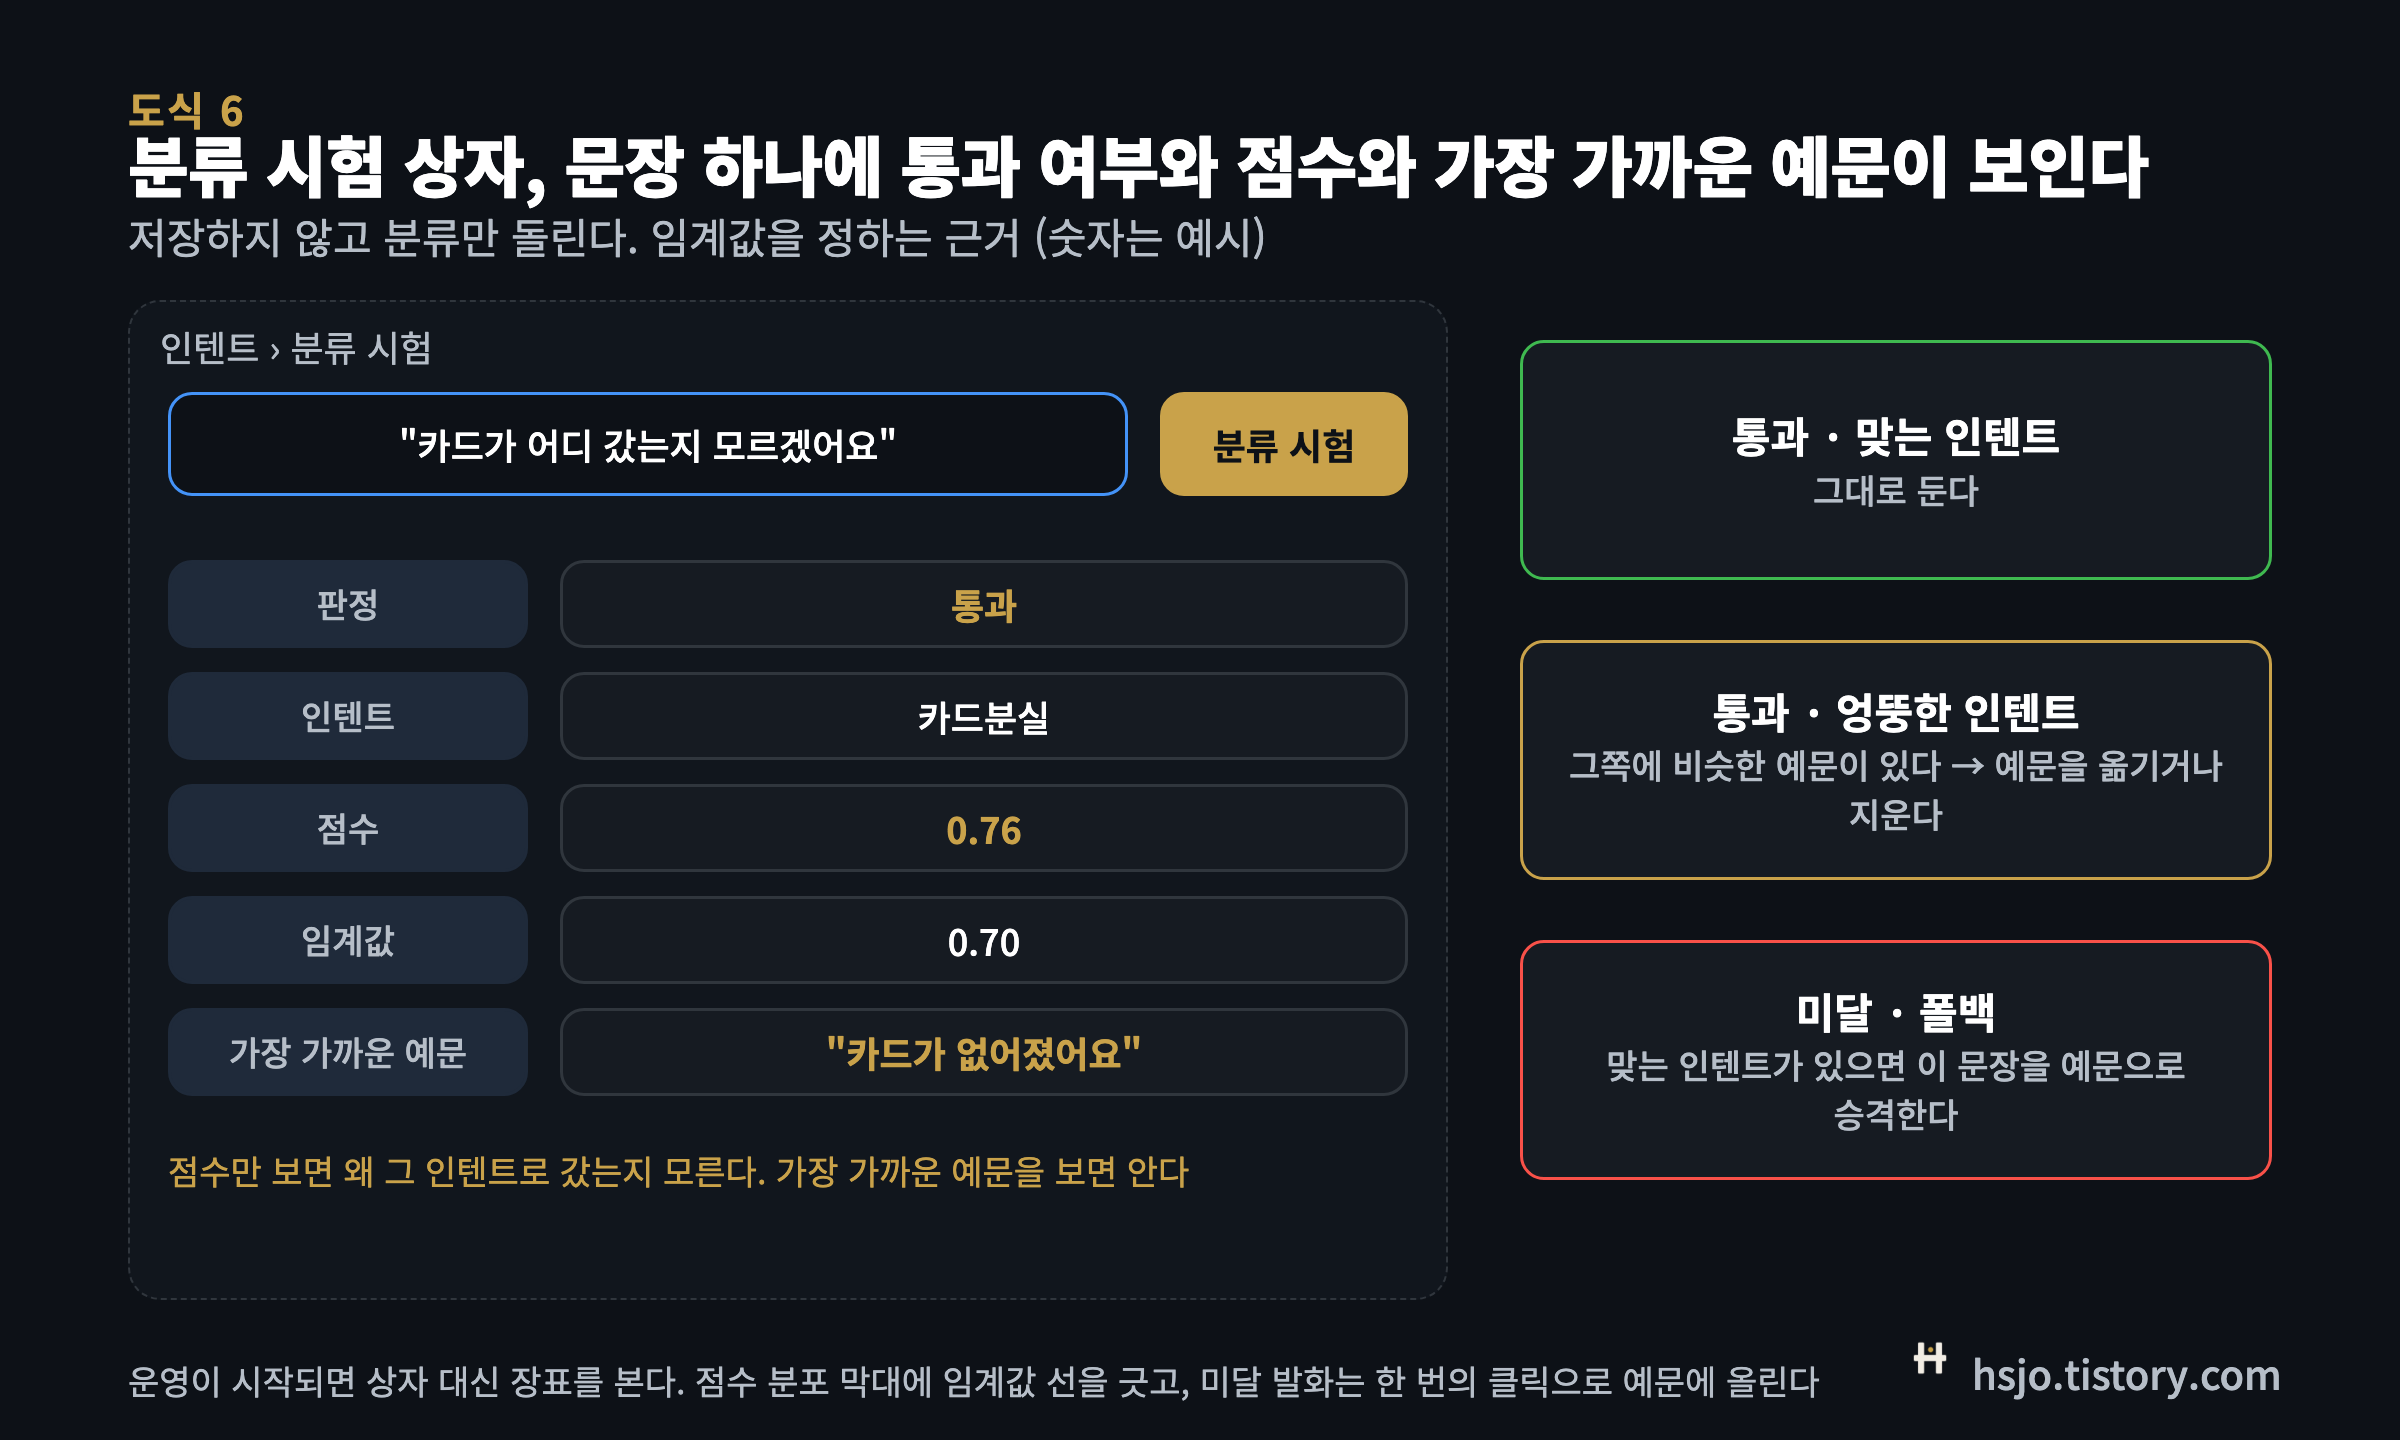
임계값을 머리로 정할 수는 없다. 그래서 인텐트 관리 화면에 분류 시험 상자를 두었다. 문장을 넣으면 저장하지 않고 분류만 돌려, 어느 인텐트로 갔는지, 점수가 얼마였는지, 임계값이 얼마였는지, 어느 예문과 가장 가까웠는지를 보여 준다. 마지막 칸이 중요하다. 점수만 보면 왜 그 인텐트로 갔는지 알 수 없지만, 가장 가까운 예문을 보면 안다. "카드가 어디 갔는지 모르겠어요"가 카드분실로 갔다면 "카드가 없어졌어요"라는 예문 덕분이고, 엉뚱한 인텐트로 갔다면 그쪽에 비슷한 예문이 있는 것이다. 벡터 검색이 "왜"를 글자로 설명하지 못하는 약점을 이 칸이 메운다.
운영이 시작되면 상자 대신 장표를 본다. 인텐트별 점수의 분포를 막대로 그리고 임계값을 선으로 긋는다. 선 바로 아래에 막대가 몰려 있으면 선이 높은 것이고, 선 바로 위에 통과한 것들이 몰려 있는데 그 뒤에 사용자가 이탈했다면 오분류를 의심한다. 임계값에 미달해 폴백으로 간 발화 원문은 목록으로 쌓이고, 그중 맞는 인텐트가 있는 것은 한 번의 클릭으로 그 인텐트의 예문으로 올린다. 올리는 순간 벡터가 저장되므로 다음 분류부터 반영된다. 예문 목록은 CSV로 내보내고 가져온다. 운영자가 엑셀에서 예문을 다듬어 다시 올리는 일이 많기 때문이고, 가져올 때 기존 인텐트의 임계값 같은 설정은 덮어쓰지 않는다.
가짜 임베딩으로 세 번 틀렸다
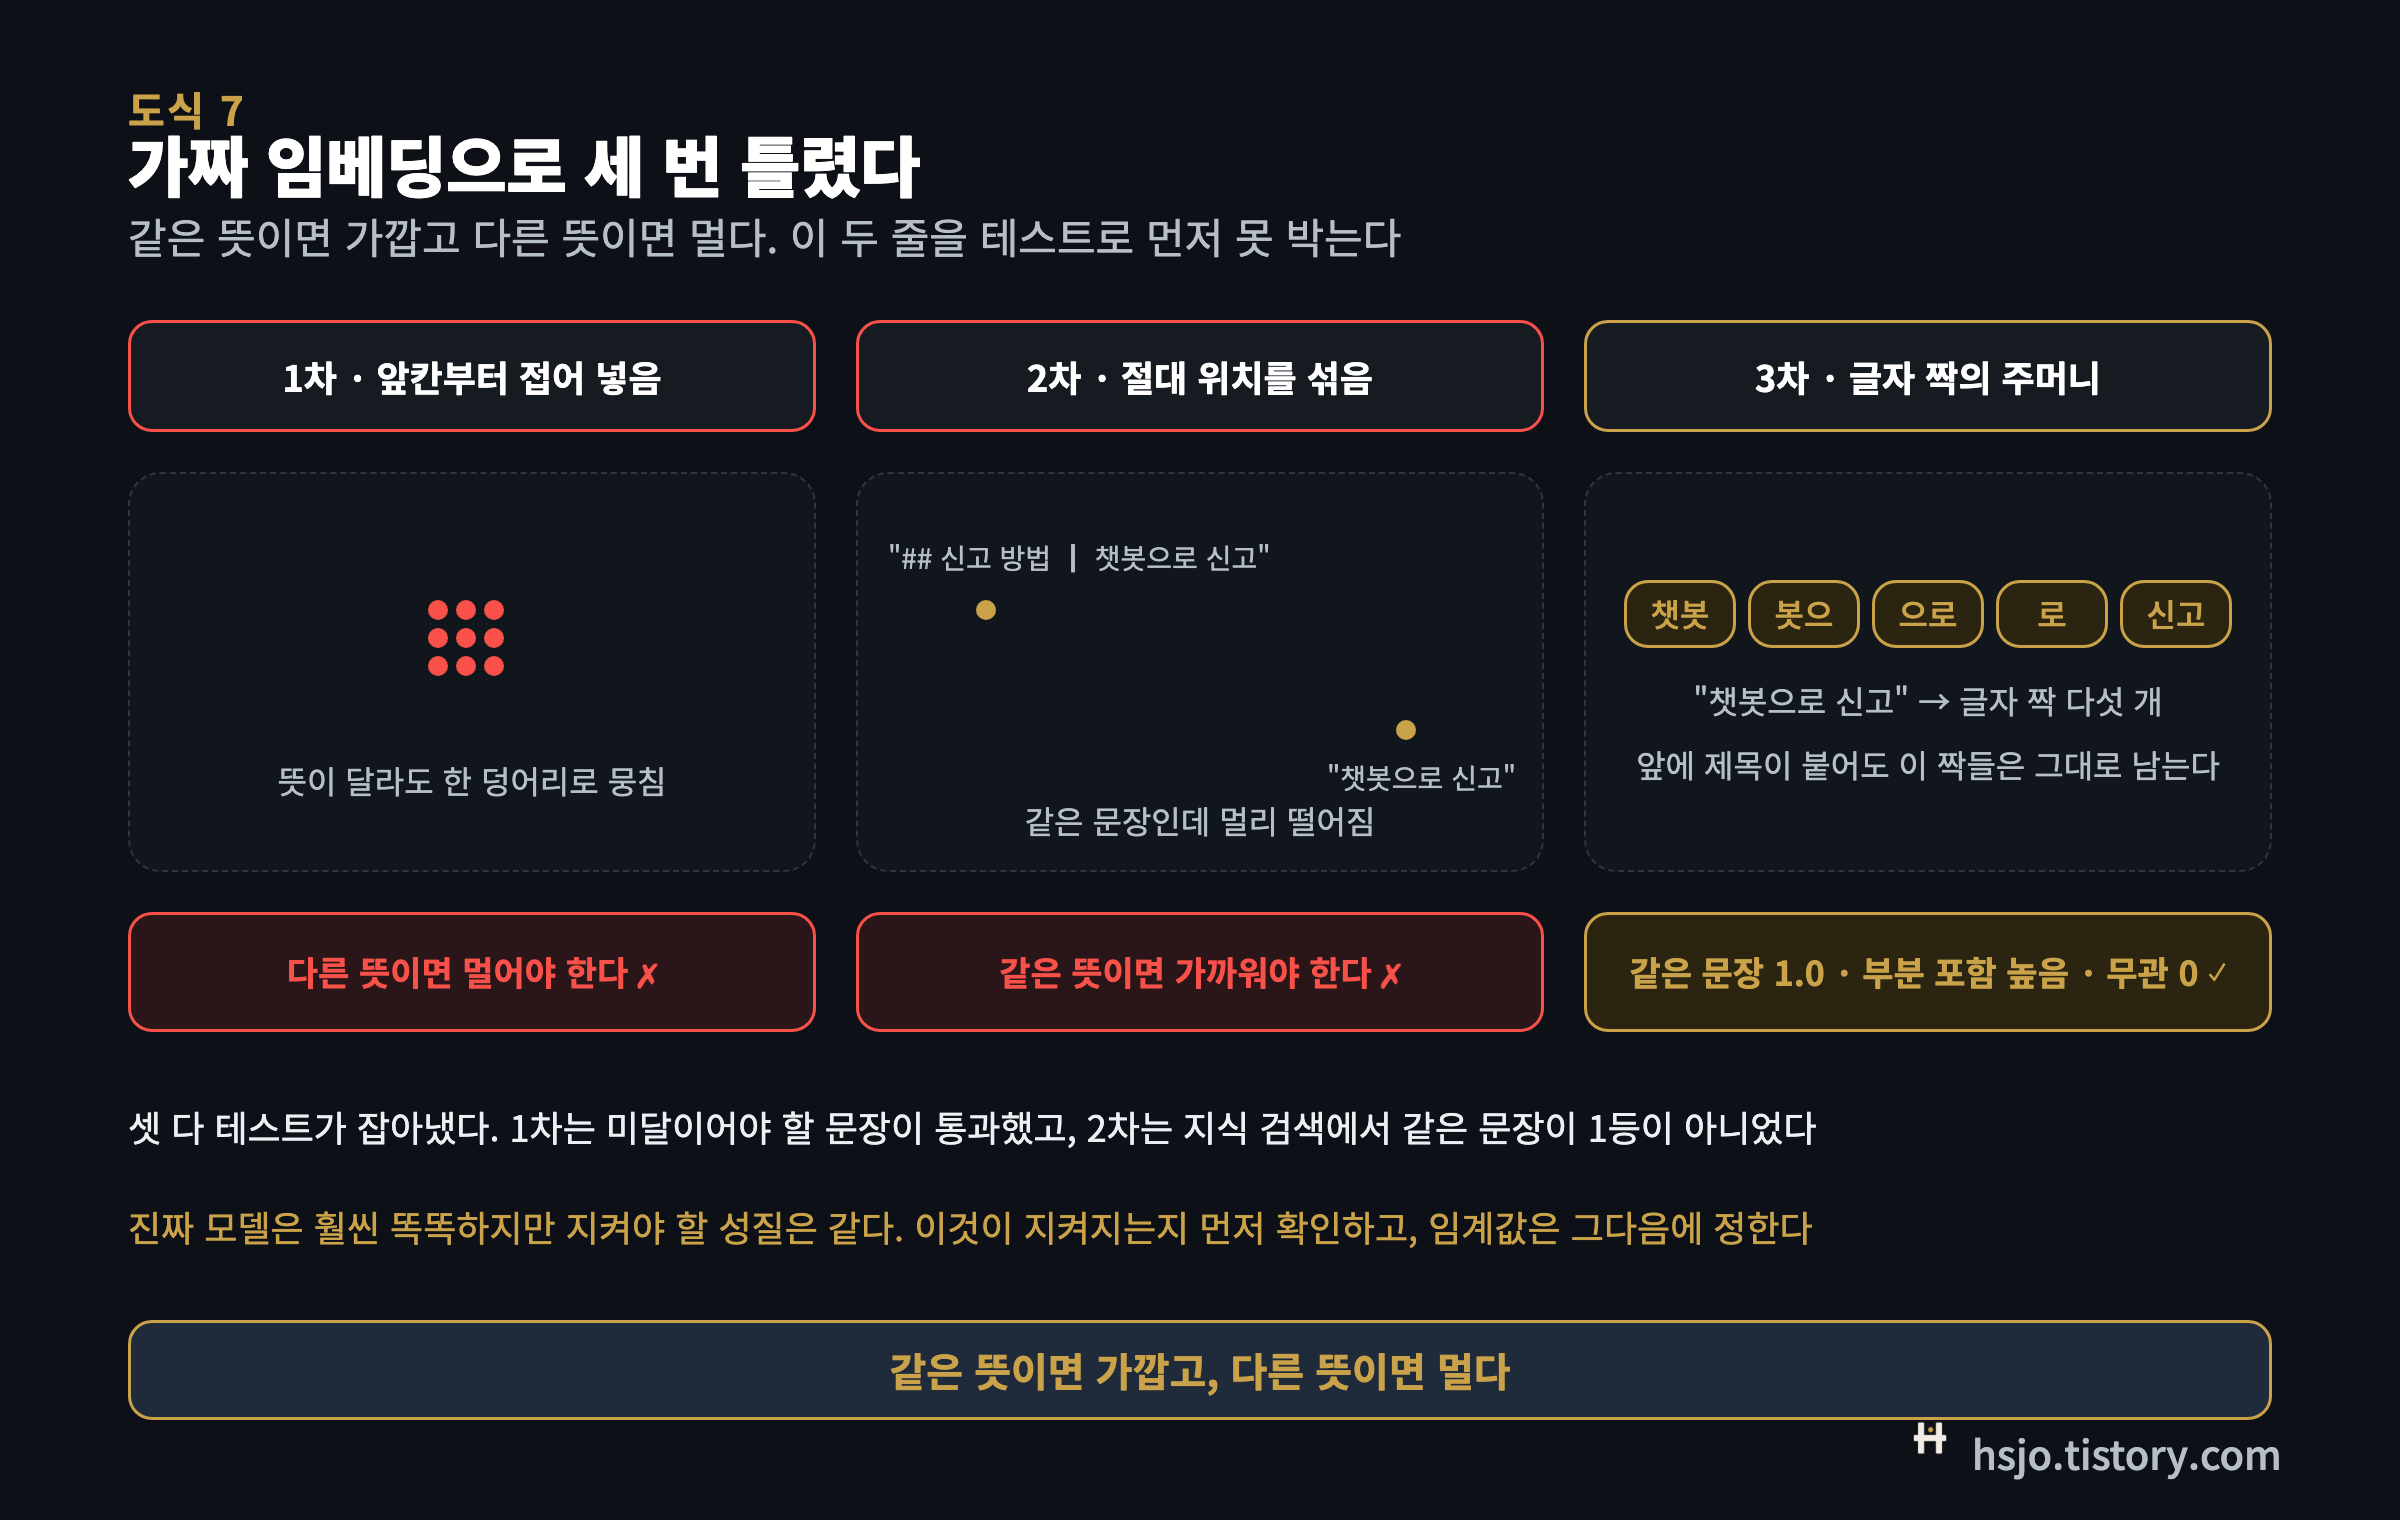
개발 중에는 진짜 임베딩 모델을 매번 돌릴 수 없어서 가짜 임베딩을 쓴다. 문장을 받아 모양만 같은 벡터를 돌려주는 함수다. 테스트는 이 가짜로 "저장했다가 검색하면 나오는가"를 확인한다. 그런데 가짜라도 벡터 검색이 성립하려면 지켜야 할 성질이 있었고, 그것을 세 번 틀리고 나서야 알았다.
| 차수 | 만든 방식 | 생긴 문제 | 잡아낸 테스트 |
| 1차 | 글자를 앞칸부터 차례로 접어 넣음 | 짧은 문장끼리 방향이 비슷해져 엉뚱한 문장도 0.7을 넘음 |
미달이어야 할 문장이 통과 |
| 2차 | 글자의 절대 위치를 섞어 흩뿌림 | 제목이 앞에 붙은 조각과 원문 질문이 전혀 다른 벡터가 되어 같은 문장도 못 찾음 |
지식 검색에서 같은 문장이 1등이 아님 |
| 3차 | 연속 두 글자(바이그램, bigram)을 세어 주머니에 담음 |
같은 문장 1.0, 부분 포함은 높음, 무관은 0 근처 |
둘 다 통과 |
1차는 "다른 뜻이면 멀어야 한다"를 어겼고, 2차는 "같은 뜻이면 가까워야 한다"를 어겼다. 3차가 둘을 함께 지킨 이유는 글자의 위치를 버리고 글자 짝의 개수만 세었기 때문이다. 제목이 앞에 붙어도 뒤의 글자 짝은 그대로 남는다. 진짜 모델은 이보다 훨씬 똑똑하지만 지켜야 할 성질은 같다. 같은 뜻이면 가깝고 다른 뜻이면 멀다. 이 두 줄을 테스트로 먼저 못 박아 두지 않으면, 검색이 틀려도 모델 탓인지 저장 탓인지 임계값 탓인지 가를 수 없다. 테스트가 세 번 잡아 주지 않았으면 진짜 모델을 붙인 뒤에 같은 문제를 더 비싸게 만났을 것이다.
실제로 돌아간 세 장면
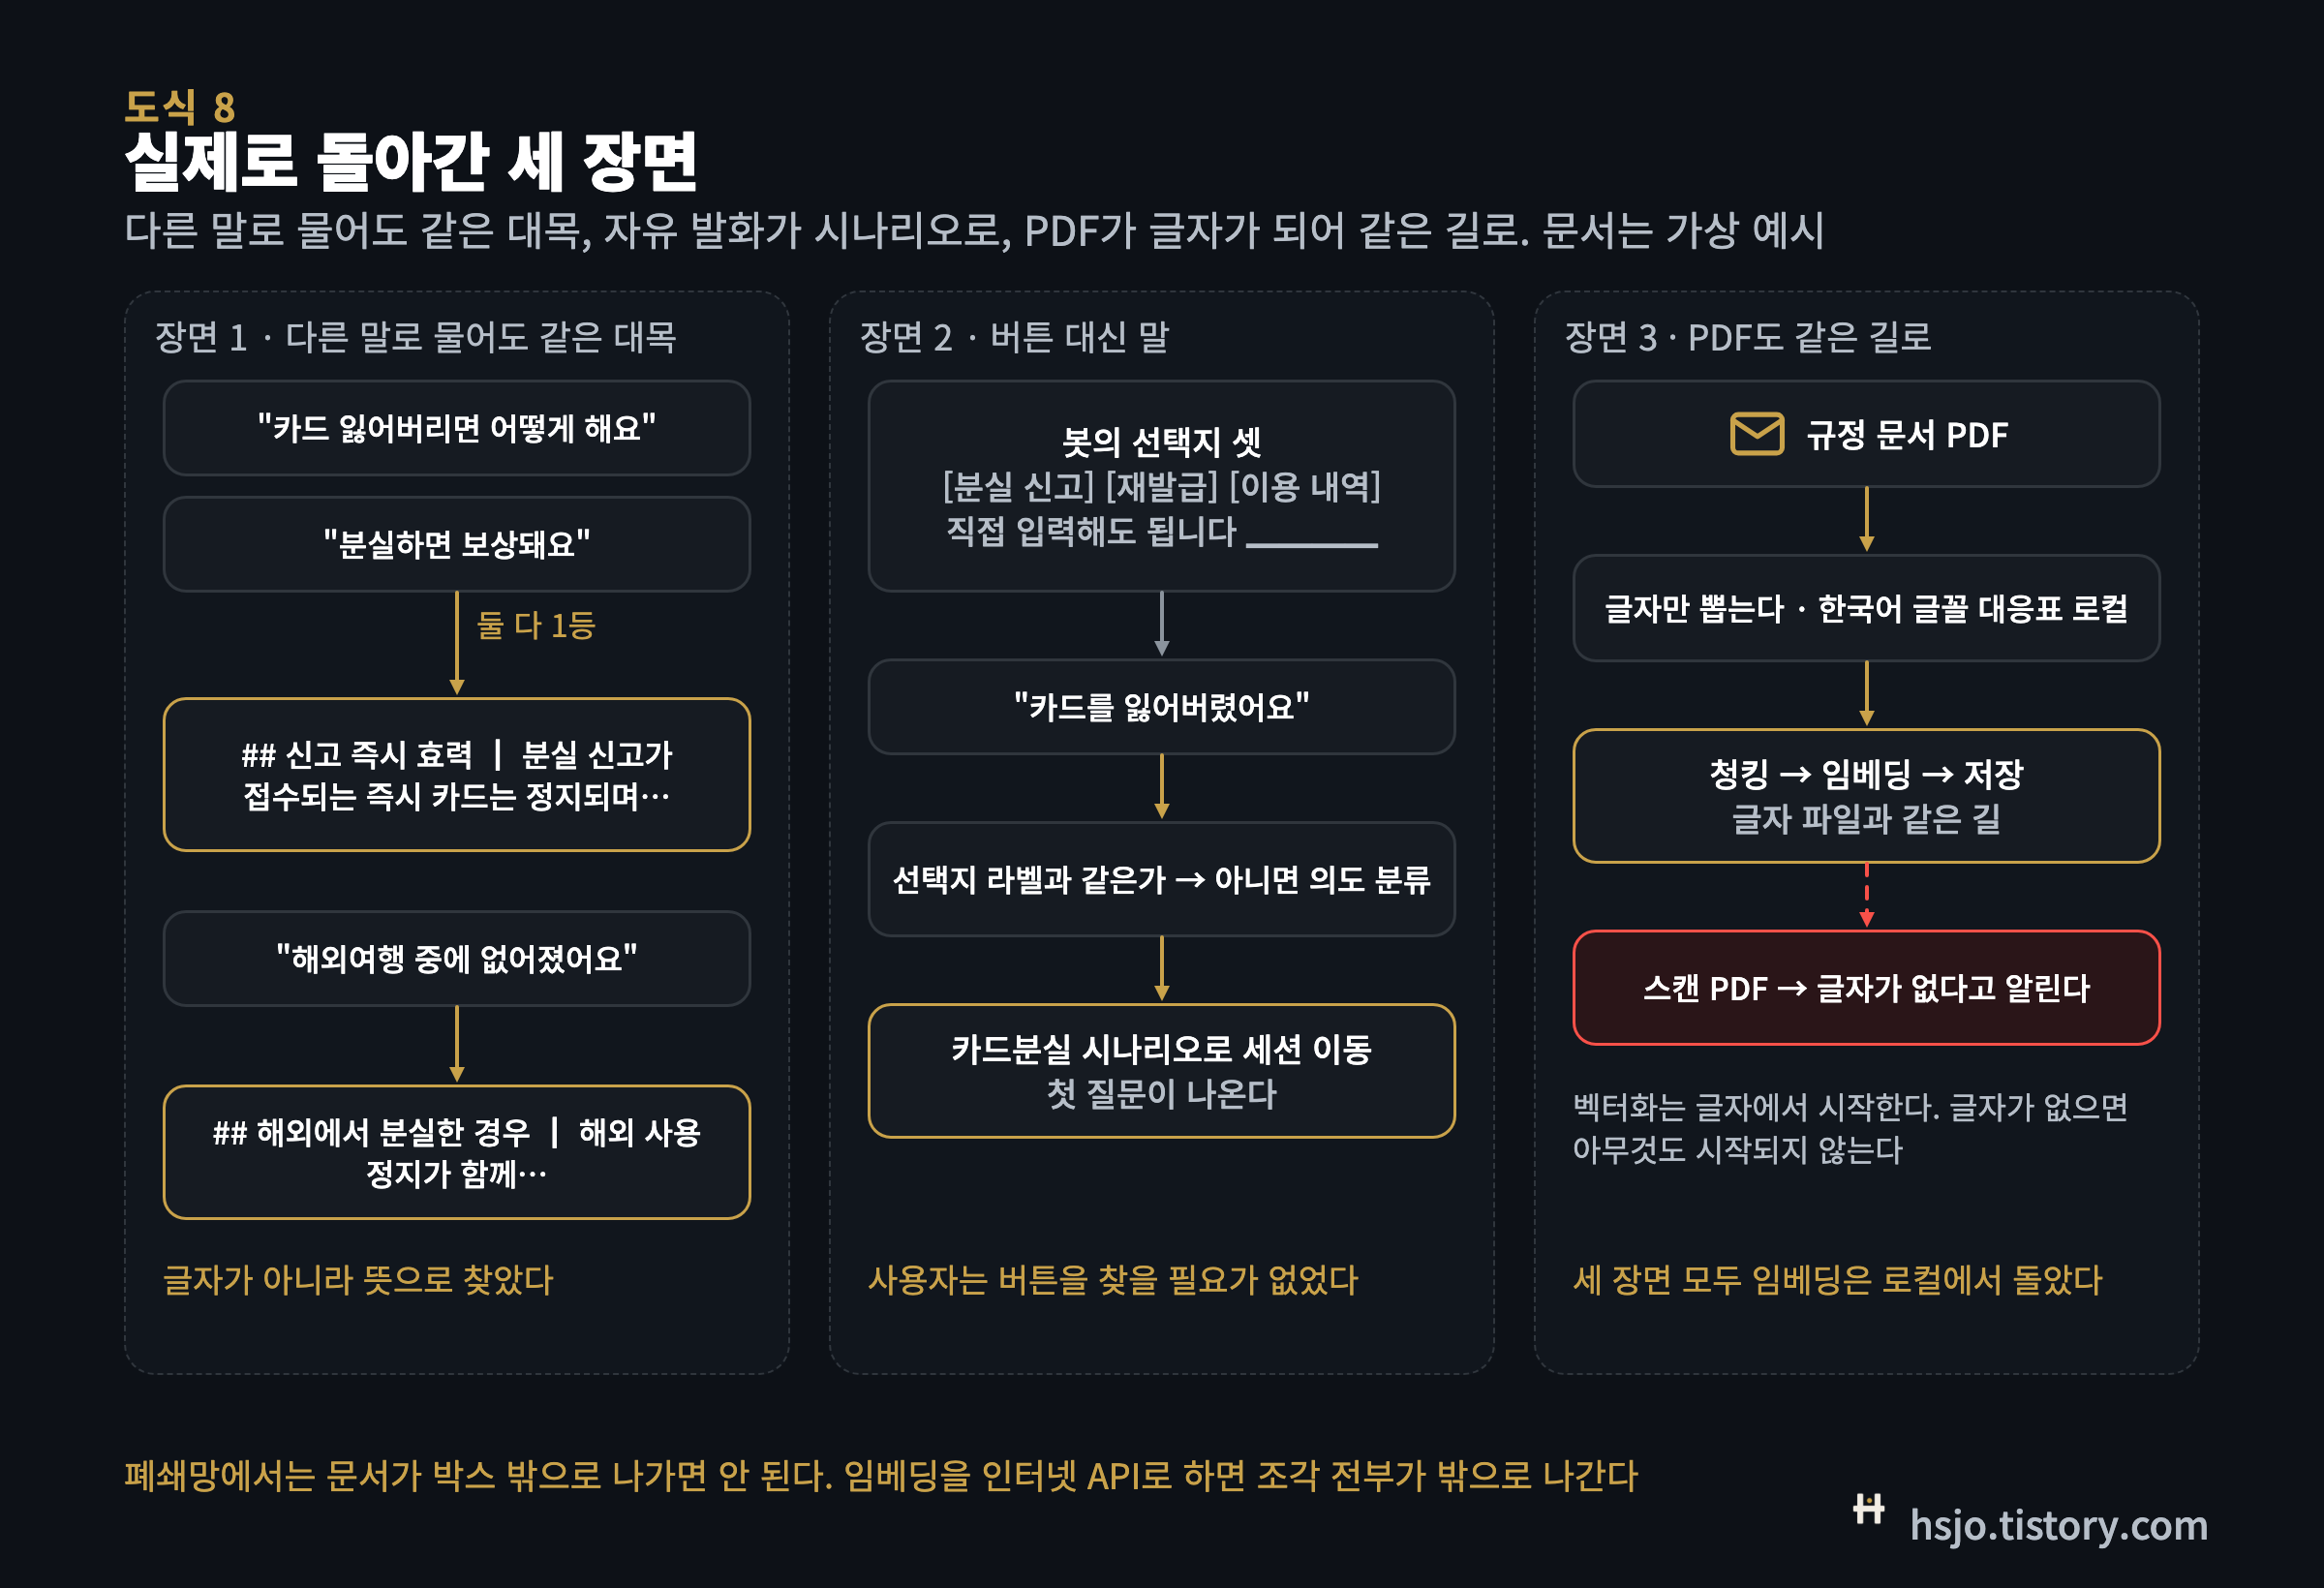
첫째 장면은 도입의 것이다. "카드 분실 신고 안내"라는 가상 규정 문서를 올린다. 문서는 제목 경계에서 잘려 "신고 즉시 효력", "신고 방법", "해외에서 분실한 경우" 같은 조각이 되고 조각마다 벡터가 붙는다. 채팅에서 "카드 잃어버리면 어떻게 해요"라고 묻는다. 1등은 "분실 신고가 접수되는 즉시 카드는 정지되며"로 시작하는 조각이다. "분실하면 보상돼요"라고 물어도 같은 조각이 1등이고, "해외여행 중에 없어졌어요"라고 물으면 해외 분실 조각이 올라온다. 글자가 아니라 뜻으로 찾았다는 것이 이 장면에서 눈에 보인다.
둘째 장면은 버튼 화면에서 일어난다. 봇이 선택지 셋을 보여 주는데 사용자가 버튼을 누르지 않고 "카드를 잃어버렸어요"라고 친다. 봇 엔진은 그 문장이 선택지 라벨과 같은지 먼저 보고, 아니면 의도 분류로 넘긴다. 분류가 카드분실 인텐트를 임계값 이상으로 고르면 세션이 카드분실 시나리오로 옮겨 타고 첫 질문이 나온다. 사용자는 버튼을 찾을 필요가 없었다. 공개 채팅 화면의 버튼 아래에 "직접 입력해도 됩니다"라는 입력칸이 있는 이유다.
셋째 장면은 PDF다. 현장의 규정 문서는 대부분 PDF라서 글자 파일만 받는 것으로는 부족했다. PDF에서 글자만 뽑아내는 부품을 붙였고, 한국어 PDF의 글자가 깨지지 않도록 글꼴 대응표를 로컬에 두었다. 뽑아낸 글자는 글자 파일과 같은 길, 그러니까 청킹과 임베딩과 저장으로 들어간다. 스캔한 PDF는 글자가 아니라 그림이라 뽑을 것이 없고, 그때는 "글자가 없는 문서"라고 알려 준다. 벡터화는 글자에서 시작하므로 글자가 없으면 아무것도 시작되지 않는다.
세 장면 모두 임베딩이 로컬에서 돌았다. 폐쇄망에서는 문서가 박스 밖으로 나가면 안 되므로 임베딩 모델도 안에 있어야 한다. 인터넷 API로 임베딩을 하면 문서 조각 전부가 밖으로 나간다. 지식 검색의 조각이든 의도 분류의 예문이든 마찬가지다.
마무리
"같은 뜻을 다른 말로 물어도 찾아낸다"는 문장은 마법처럼 들리지만 안을 열면 세 가지뿐이다. 문장을 숫자 목록으로 바꾸고, 두 목록이 같은 방향을 보는 정도를 재고, 가까운 순으로 줄을 세운다. 그 위에 사람이 정하는 것이 둘 있다. 어디서부터 닮았다고 볼지(임계값)와, 틀렸을 때 어디를 볼지(시험 상자와 점수 원값). 가짜 임베딩으로 세 번 틀리면서 배운 것도 결국 그 두 줄이었다. 같은 뜻이면 가깝고 다른 뜻이면 멀다. 이것이 지켜지는지를 먼저 확인하고, 임계값은 그다음에 정한다.
다음 글은 봇이 대화의 어디까지 왔는지를 들고 있는 컨텍스트다. 벡터가 "무엇을 묻는가"를 찾아 준다면, 컨텍스트는 "지금 어디까지 왔는가"를 기억한다.
'tech' 카테고리의 다른 글
| SIP가 연결하고 RTP가 나른다, 인터넷 전화는 두 길로 간다 (0) | 2026.10.18 |
|---|---|
| 대화를 이어 가는 것은 기억이 아니라 기록이다, 컨텍스트 (0) | 2026.10.18 |
| 인공지능에게 가르치지 말고 읽을 문서를 건넨다, RAG과 LLM 연동 (0) | 2026.10.17 |
| 답을 찾아 주던 봇이 일을 끝낸다, Agentic AICC (0) | 2026.10.17 |
| 플랫폼이 달라도 챗봇을 움직이는 말은 같다, 챗봇 용어 정리 (0) | 2026.10.14 |